CRSRuleMiner
——针对cat命令的CRS规则挖掘
说明:文字页保留原始分页文本,图页嵌入原图。
目录与项目简介
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
| CRSRuleMiner
——针对cat命令的CRS规则挖掘
目录:
零:项目简介
一:开发环境
二:整体项目架构及文件说明
三:主要功能
- 核心目标
- 功能模块
- 评测体系
四:核心代码
- 自研变种(generate_variants.py)
- 聚类(cluster_training_set.py)
- 规则投票(vote_cluster_regex.py)
- WAF运行时验证(waf_probe.py)
五:实验结果
- 聚类阶段
- 规则投票阶段
- 规则压缩对比
- 冻结一次、只测一次的公共来源hold-out
- 误报与边界测试
- CRS运行时对比
- 总结
六:EXE打包与安装包制作
七:AI 对话记录与项目历程
零:项目简介:
CRSRuleMiner 项目,是面向 OWASP CRS 的 cat 命令注入绕过规则自动挖掘项目。本项目从 165
条真实攻击样本出发,通过自研变种生成、SBERT 语义聚类、HDBSCAN 密度分簇和 GPT5.5
三次采样投票,自动归纳出 11 条紧凑检测规则。
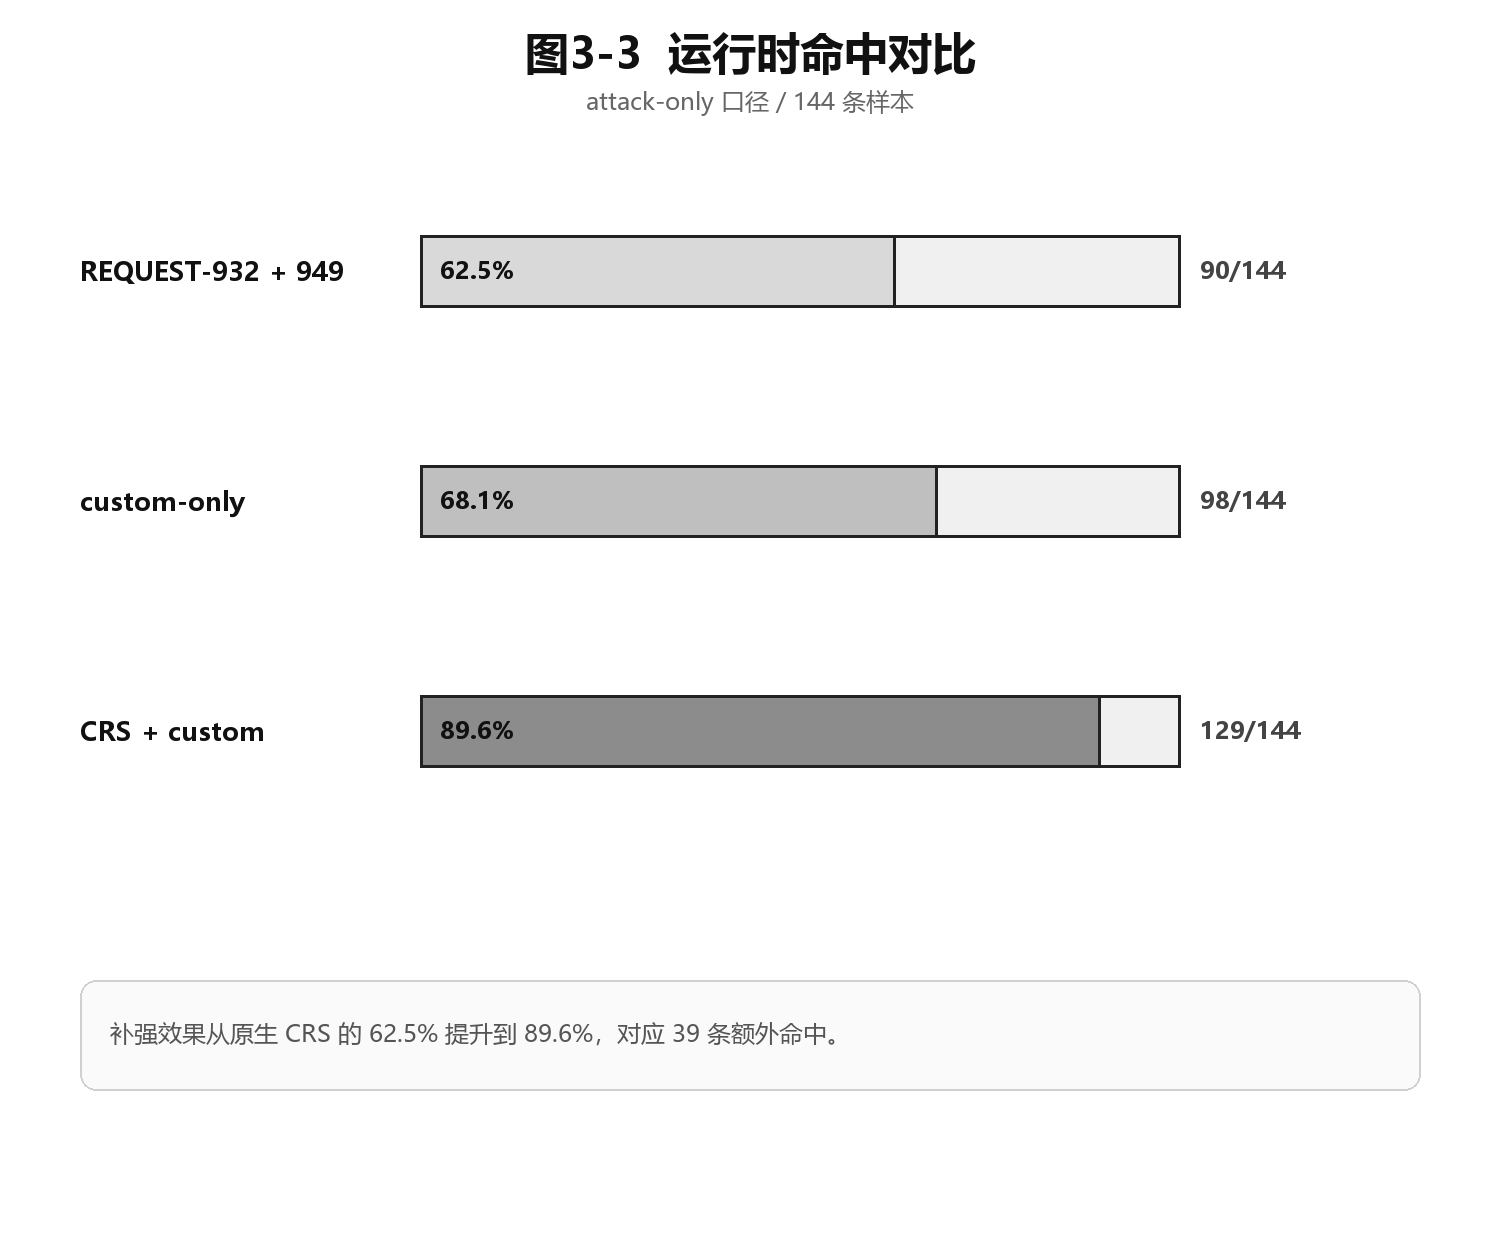
规则在 144 条真实攻击集上命中 129 条,在 5000 条混合日志上实现零误报,且通过 CRS 932
剥离对比验证了独立净增量。项目完整覆盖了从样本收集、规则生成到 WAF
运行时评测的工程闭环,并打包为桌面可执行程序,支持搜索、溯源与结果复核。
|
开发环境与背景说明
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
| 注:
OWASP 是研究和发布 Web 应用安全相关的知识、工具和标准的安全组织
OWASP CRS(Core Rule Set)就是这个组织发布的一套 WAF
防护规则集。它是全球最主流、应用最广泛的开源 WAF 规则库
我的规则最终要补进 CRS 里,932是CRS规则集里面的规则文件编号,REQUEST-932:专门检测
远程命令执行(RCE),管理着cat的命令注入,最终的11条规则就是要补在932这条链路上,我用 Git 把
OWASP CRS 的官方仓库从 GitHub 克隆到了本地,然后切到 v4.28.0-dev 分支,存放在项目根目录的 .tmp_crs/
文件夹里这样就可以直接引用 CRS 的原始规则文件、配置模板和回归测试框架,在本地 WSL2
环境中加载、对比和验证自己的 11 条自定义规则。
一:开发环境
操作主机:win11
Python:3.8.10
虚拟环境:venv
Web框架:FastAPI 0.124.0
前端:Jinja2 模板 + 原生 HTML5 / CSS3 / JS
可视化:Plotly.js 3.0.1
机器学习:
torch 2.4.1 (计算,推理)
transformers 4.46.3(加载,管理,运行 all-minilm-l6-v2模型)
SBERT(sentence-transformers 3.2.1)(把Token化的payload编码为384维向量)
HDBSCAN 0.8.40(聚类向量)
Pandas(辅助读取训练集,统计簇的大小,统计噪声)
Numpy 1.24.4 (存向量)
Scikit-learn 1.3.2 (算轮廓系数,做消融实验,评估聚类质量)
LLM:GPT-5.5
开发工具:
codex / VS Code
PyInstarller:打包项目为exe
WSL2:提供apache进行modsecurity测试
访问方式:CRSRuleMiner.exe
二:整体项目架构及文件说明:
C:\Users\pc\Desktop\changcheng\
├── app.py #fastapi主程序
├── CRSRuleMiner.spec #pyinstaller打包配置文件
├── GreatWallCup.md
├── PR_4664.md
├── evidence_pack.md
├── static\ #静态前端
│ ├── workbench.css #工作台样式
|
整体项目架构及文件说明
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
| │ └── workbench.js #搜索,渲染,导出,溯源显示
├── templates\ #前端样式
│ └── index.html #主页面骨架
├── scripts\ #脚本
│ ├── audit_noise_samples.py #从 206 条噪声中抽 40 条做人工复核,并统计全量噪声的五分类分布
│ ├── build_benign_context_docs.py #生成110条合法文本语境误报集
│ ├── build_benign_mixed.py #生成 5000 条 Apache + Nginx 混合误报压力集
│ ├── build_cat_in_context_probe.py #生成 117 条 cat 命令语境探针集
│ ├── build_custom_crs_conf.py #生成加载 11 条自定义规则的 CRS 配置文件
│ ├── build_custom_only_fp_sample.py #生成 500 条 custom-only 纯误报抽样集
│ ├── build_independent_blind_eval.py #生成 64 条独立盲测集与 80 条跨命令试点
│ ├── build_locked_eval.py #生成 359 条冻结泛化备选集与 5000 条基础误报日志集
│ ├── check_env.py # 检查 Python 依赖和运行环境是否就绪
│ ├── clean_locked_generalization.py # 按语义清洗原始备选集合为裸 payload
│ ├── cluster_training_set.py #三步簇产出结果
│ ├── compare_rule_versions.py # 规则压缩前后消融对比
│ ├── crs_932_blocking_compare.sh # 只加载 932+949 规则,重跑冻结集
│ ├── crs_932_compare.sh # 对比 CRS 基线与本项目补丁的命中差异
│ ├── crs_932_plus_custom_compare.sh # CRS + 自定义规则联合测试
│ ├── custom_only_500_probe.sh # 对 custom-only 纯误报抽样做 WAF 运行时探针
│ ├── custom_only_compare.sh # 只加载自定义规则,单独测误报
│ ├── extract_cluster_patterns.py #从每个簇提取正则骨架
│ ├── freeze_eval_lockin.py
│ ├── generate_variants.py #165→737条自研变种
│ ├── rank_review_candidates.py
│ ├── split_homologous_dataset.py #切分变种集为训练集和同源测试集
│ ├── test_rules.py #离线正则脚本
│ ├── vote_cluster_regex.py #gpt三次投票筛选
│ ├── waf_probe.py # 向本地 WAF/CRS 发送批量请求并统计 blocked/allowed
│ ├── waf_probe_detail.py # 逐行输出每条 payload 的详细拦截结果
│ ├── wsl_inspect_crs_images.sh # 检查 CRS 临时目录中的镜像/引用内容
│ ├── wsl_setup_apache_crs.sh # 在 WSL2 中搭建 Apache + ModSecurity + CRS 环境
│ ├── wsl_test_baseline.sh # 测试基线 CRS 的冻结集表现
│ └── wsl_trust_docker_proxy.sh # 给 Docker 代理证书装信任并重启 Docker
├── dist\ # PyInstaller 打包输出目录
│ ├── CRSRuleMiner.exe # 正式桌面交付产物
│ └── .tmp_tools\workbench_state_cache.json # 工作台运行状态缓存
├── ApacheLog-Dataset\ # Apache 日志数据集
|
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
| ├── .tmp_crs\ # 临时克隆的 OWASP CRS 源码,用于 WAF 测试
├── .tmp_tools\ # 外部工具缓存(RegexGenerator、Regexploit 等)
├── .claude\
├── venv\ # Python 虚拟环境,所有第三方依赖安装在此
├── real_samples.txt #原始165条样本集
├── homologous_test.txt #从变种样本集中拿出的100条同源样本集
├── locked_generalization_set.txt #359条备选样本集,冻结
├── locked_generalization_real.txt #149条清洗备选样本集,用于离线测试
├── locked_generalization_attack_real.txt #144条彻底清洗样本集,waf测试
├── benign_logs.txt #误报集:apache5000条真实日志
├── benign_logs_mixed.txt # 误报集:Apache + Nginx 混合日志 5000 条
├── false_positive_logs_public.txt # 误报集:多源公开 HTTP 日志 2037 条
├── false_positive_logs_stress.txt # 误报集:压力版日志 5200 条,含 200 条合法 cat 子串
├── benign_context_docs.txt # 误报集:合法文本语境 110 条,刻意清掉 shell 语法痕迹
├── cat_in_context_probe.txt # 误报集:cat 命令语境探针 117 条,逼近教程命令示例边界
├── cluster_results.json # 聚类结果,含 63 个簇、206 条噪声和摘要统计
├── voting_result.json # LLM 三次采样投票结果,记录每个簇的三次输出与采纳情况
├── rule_compression_ablation.json # 15 条与 11 条规则的压缩消融对比数据
├── crs_932_attack_result.json # REQUEST-932 + 949 only attack-only 结果
├── crs_custom_attack_result.json # CRS + custom attack-only 结果
├── custom_only_attack_result.json # custom-only 攻击样本实测结果
├── custom_only_fp_500_result.json # custom-only 纯误报 500 条抽样实测结果
├── frozen_independent_blind_cat_eval.txt# 冻结一次的公共来源 hold-out 副本,64 条
├── frozen_independent_blind_manifest.json # 公共来源 hold-out 冻结清单与 SHA256
├── frozen_independent_blind_result.json # 公共来源 hold-out 冻结实测结果
├── frozen_homologous_test.txt # 冻结版同源测试集
├── frozen_locked_generalization_real.txt # 冻结版泛化集副本
├── frozen_benign_logs.txt # 冻结版误报集副本
├── frozen_false_positive_logs_public.txt # 冻结版公开误报集副本
├── frozen_false_positive_logs_stress.txt # 冻结版压力误报集副本
├── frozen_rules_final_compact.txt # 冻结版最终规则副本
├── locked_eval_manifest.json # 清洗后评测清单与来源统计
├── locked_generalization_attack_manifest.json # attack-only 冻结集的剔除行和溯源说明
├── evaluation_lockin_manifest.json # 冻结评测锁定清单,含 SHA256 与线数
├── rules.txt # 早期手工基线规则,10 条(对比实验参照)
├── rules_final.txt # 15 条阶段版最终规则(消融实验对照组)
├── rules_final_compact.txt # 当前稳定可复核的紧凑规则集,11 条
├── rules_targeted.txt # 针对特定样本收紧的规则版本,15 条
|
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
| ├── candidate_patterns.txt # 每簇候选模式骨架
├── noise_audit_sample.txt # HDBSCAN 噪声抽样复核样本,40 条
├── noise_audit_report.json # 噪声全量 206 条的五分类桶统计报告
├── portability_probe_wget_curl.txt # 跨命令试点集,80 条,验证对 wget/curl 的迁移能力
├── portability_mini_rules.txt # 跨命令试点用的 3 条最小可用规则
├── regexgenerator_best_java.txt # RegexGenerator 输出的最优 Java 正则,1 条
├── regexgenerator_dataset.json # RegexGenerator flagging 数据集
├── regexgenerator_flagging_dataset.json ## RegexGenerator flagging 数据集
├── regexgenerator_flagging_dataset_smallneg.json # 小负样本版 flagging 数据集
├── regexgen_small.json # 小规模 RegexGenerator 结果样本
├── OS-Command-Injection-Unix-Payloads.txt # 公开 Unix 命令注入 payload 集合
├── pentest-book-command-injection.md # 渗透测试命令注入参考笔记
├── portswigger-command-injection-attacker.md # PortSwigger shelling 命令注入资料整理
├── nginx_access_sample.log # Nginx 访问日志样本,37 行
├── nginx_logs_raw.txt # 原始 Nginx 日志,51462 行
├── Apache_2k.log # Apache 访问日志原始样本,2000 行
└── ApacheLog-Dataset/src/data/promjetDec2021.log # 原始 Apache 访问日志,137510 行
项目依赖:
FastAPI 0.124.4/Uvicorn 0.33.0:Web 服务与接口层。
sentence-transformers 3.2.1:SBERT 文本向量化。
transformers 4.46.3:底层模型加载与管理。
torch 2.4.1:推理与张量计算。
hdbscan 0.8.40:密度聚类。
scikit-learn 1.3.2:评估、消融和统计分析。
openai 2.2.0:LLM 投票生成规则。
numpy 1.24.4/pandas 2.0.3:数据处理与汇总。
pyinstaller 6.14.1:桌面版打包。
httpx 0.28.1:OpenAI 兼容接口调用。
4. 配置API密钥
创建 .env 文件,写入:OPENAI_API_KEY=(GPT5.5)
三:主要功能
核心目标
本项目围绕有关cat命令的绕过注入,该项目以真实样本为基准,自动产出检测规则,生成的规则可维护,可
复现,并尽量把规则整理成 CRS 风格SecRule,为后续 PR 集成做准备
2. 功能模块
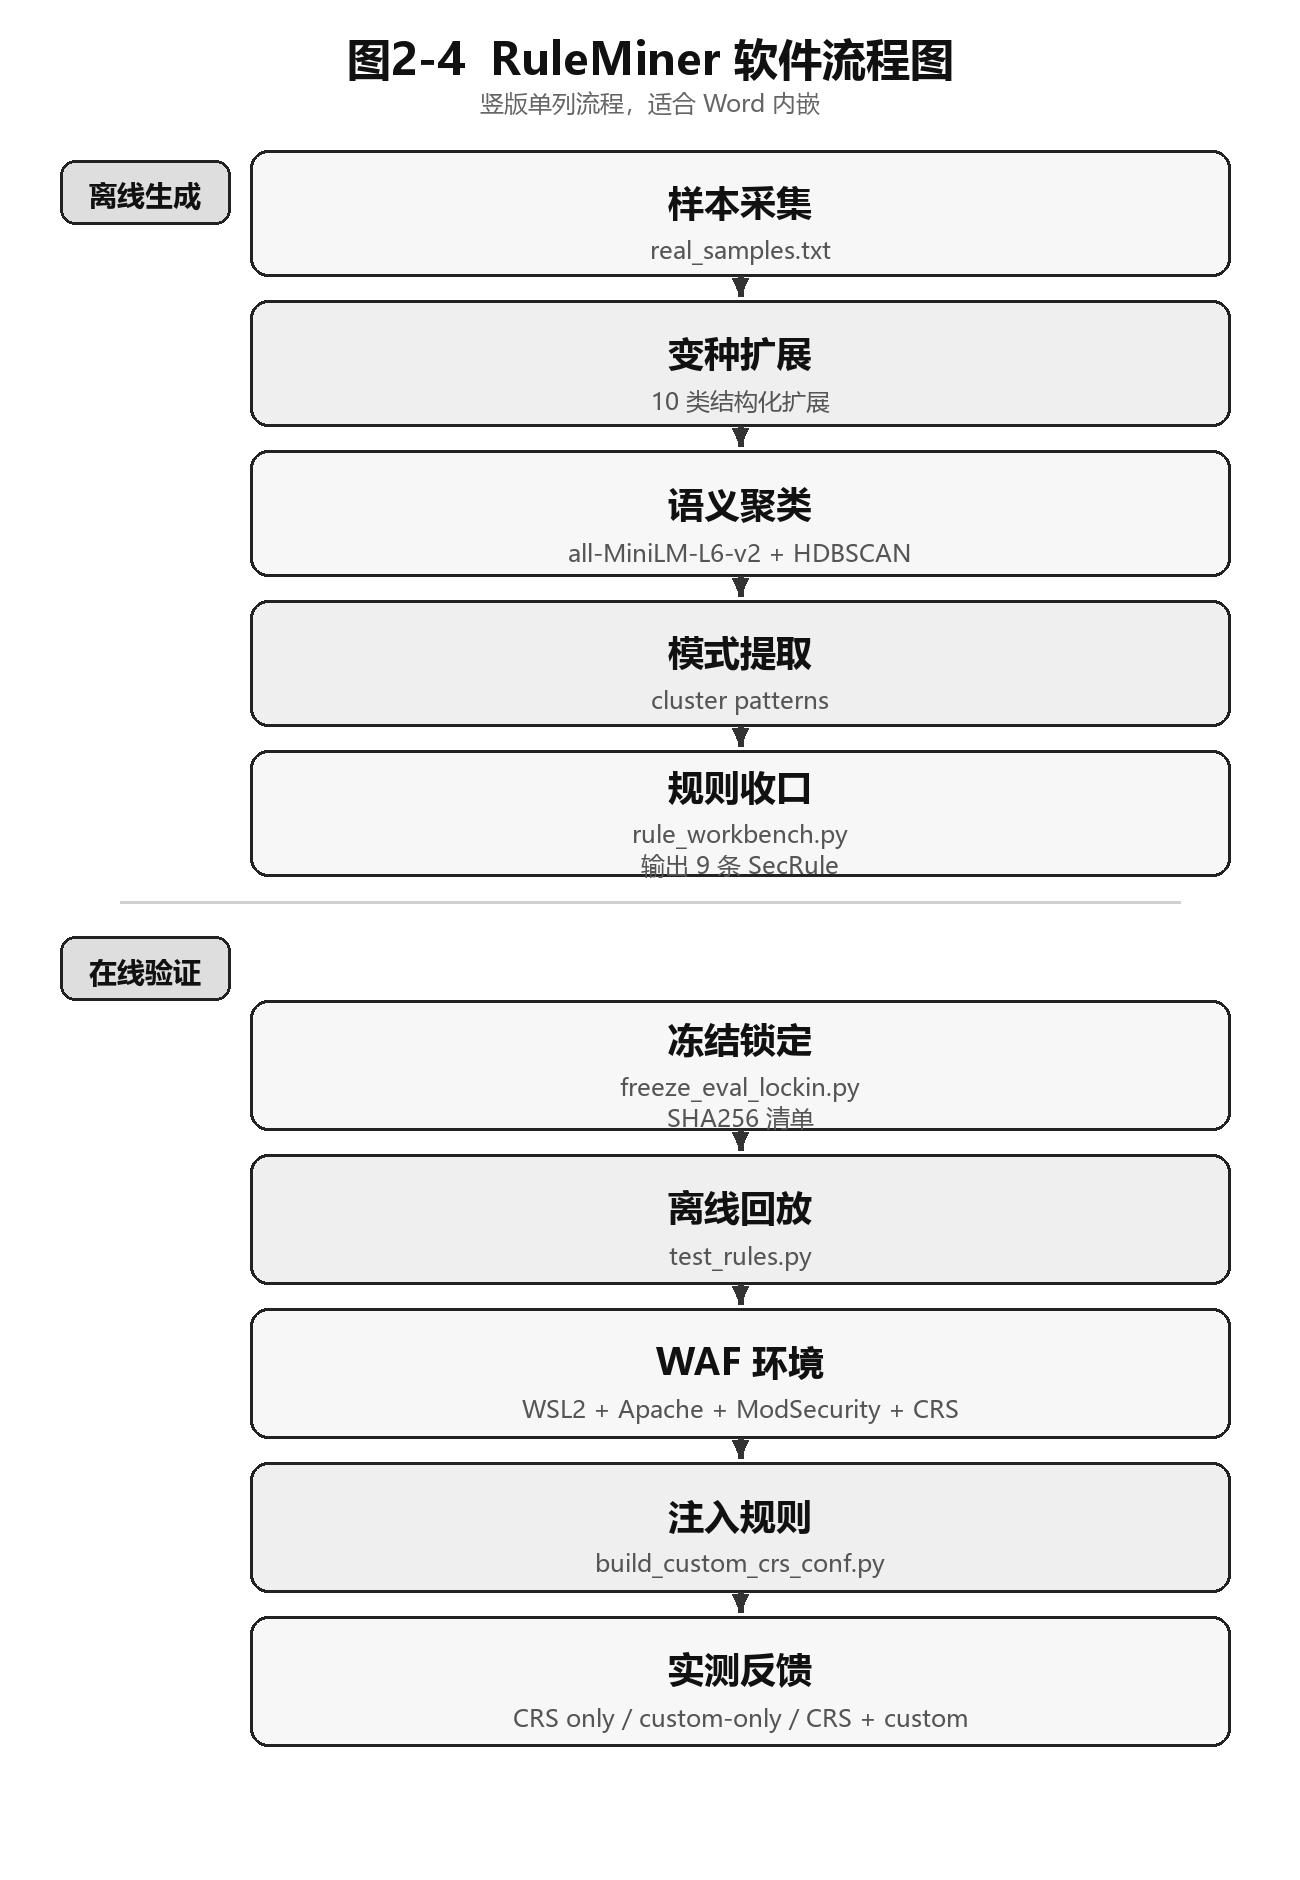
变种生成—generate_variants.py:从 165 条真实收集的catpayload 生成 737 条自研变种,覆盖 10 种绕过维度
数据切分—split_homologous_dataset.py:从混合池中切出 100 条同源测试集,剩余作为训练集
|
主要功能与核心代码
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
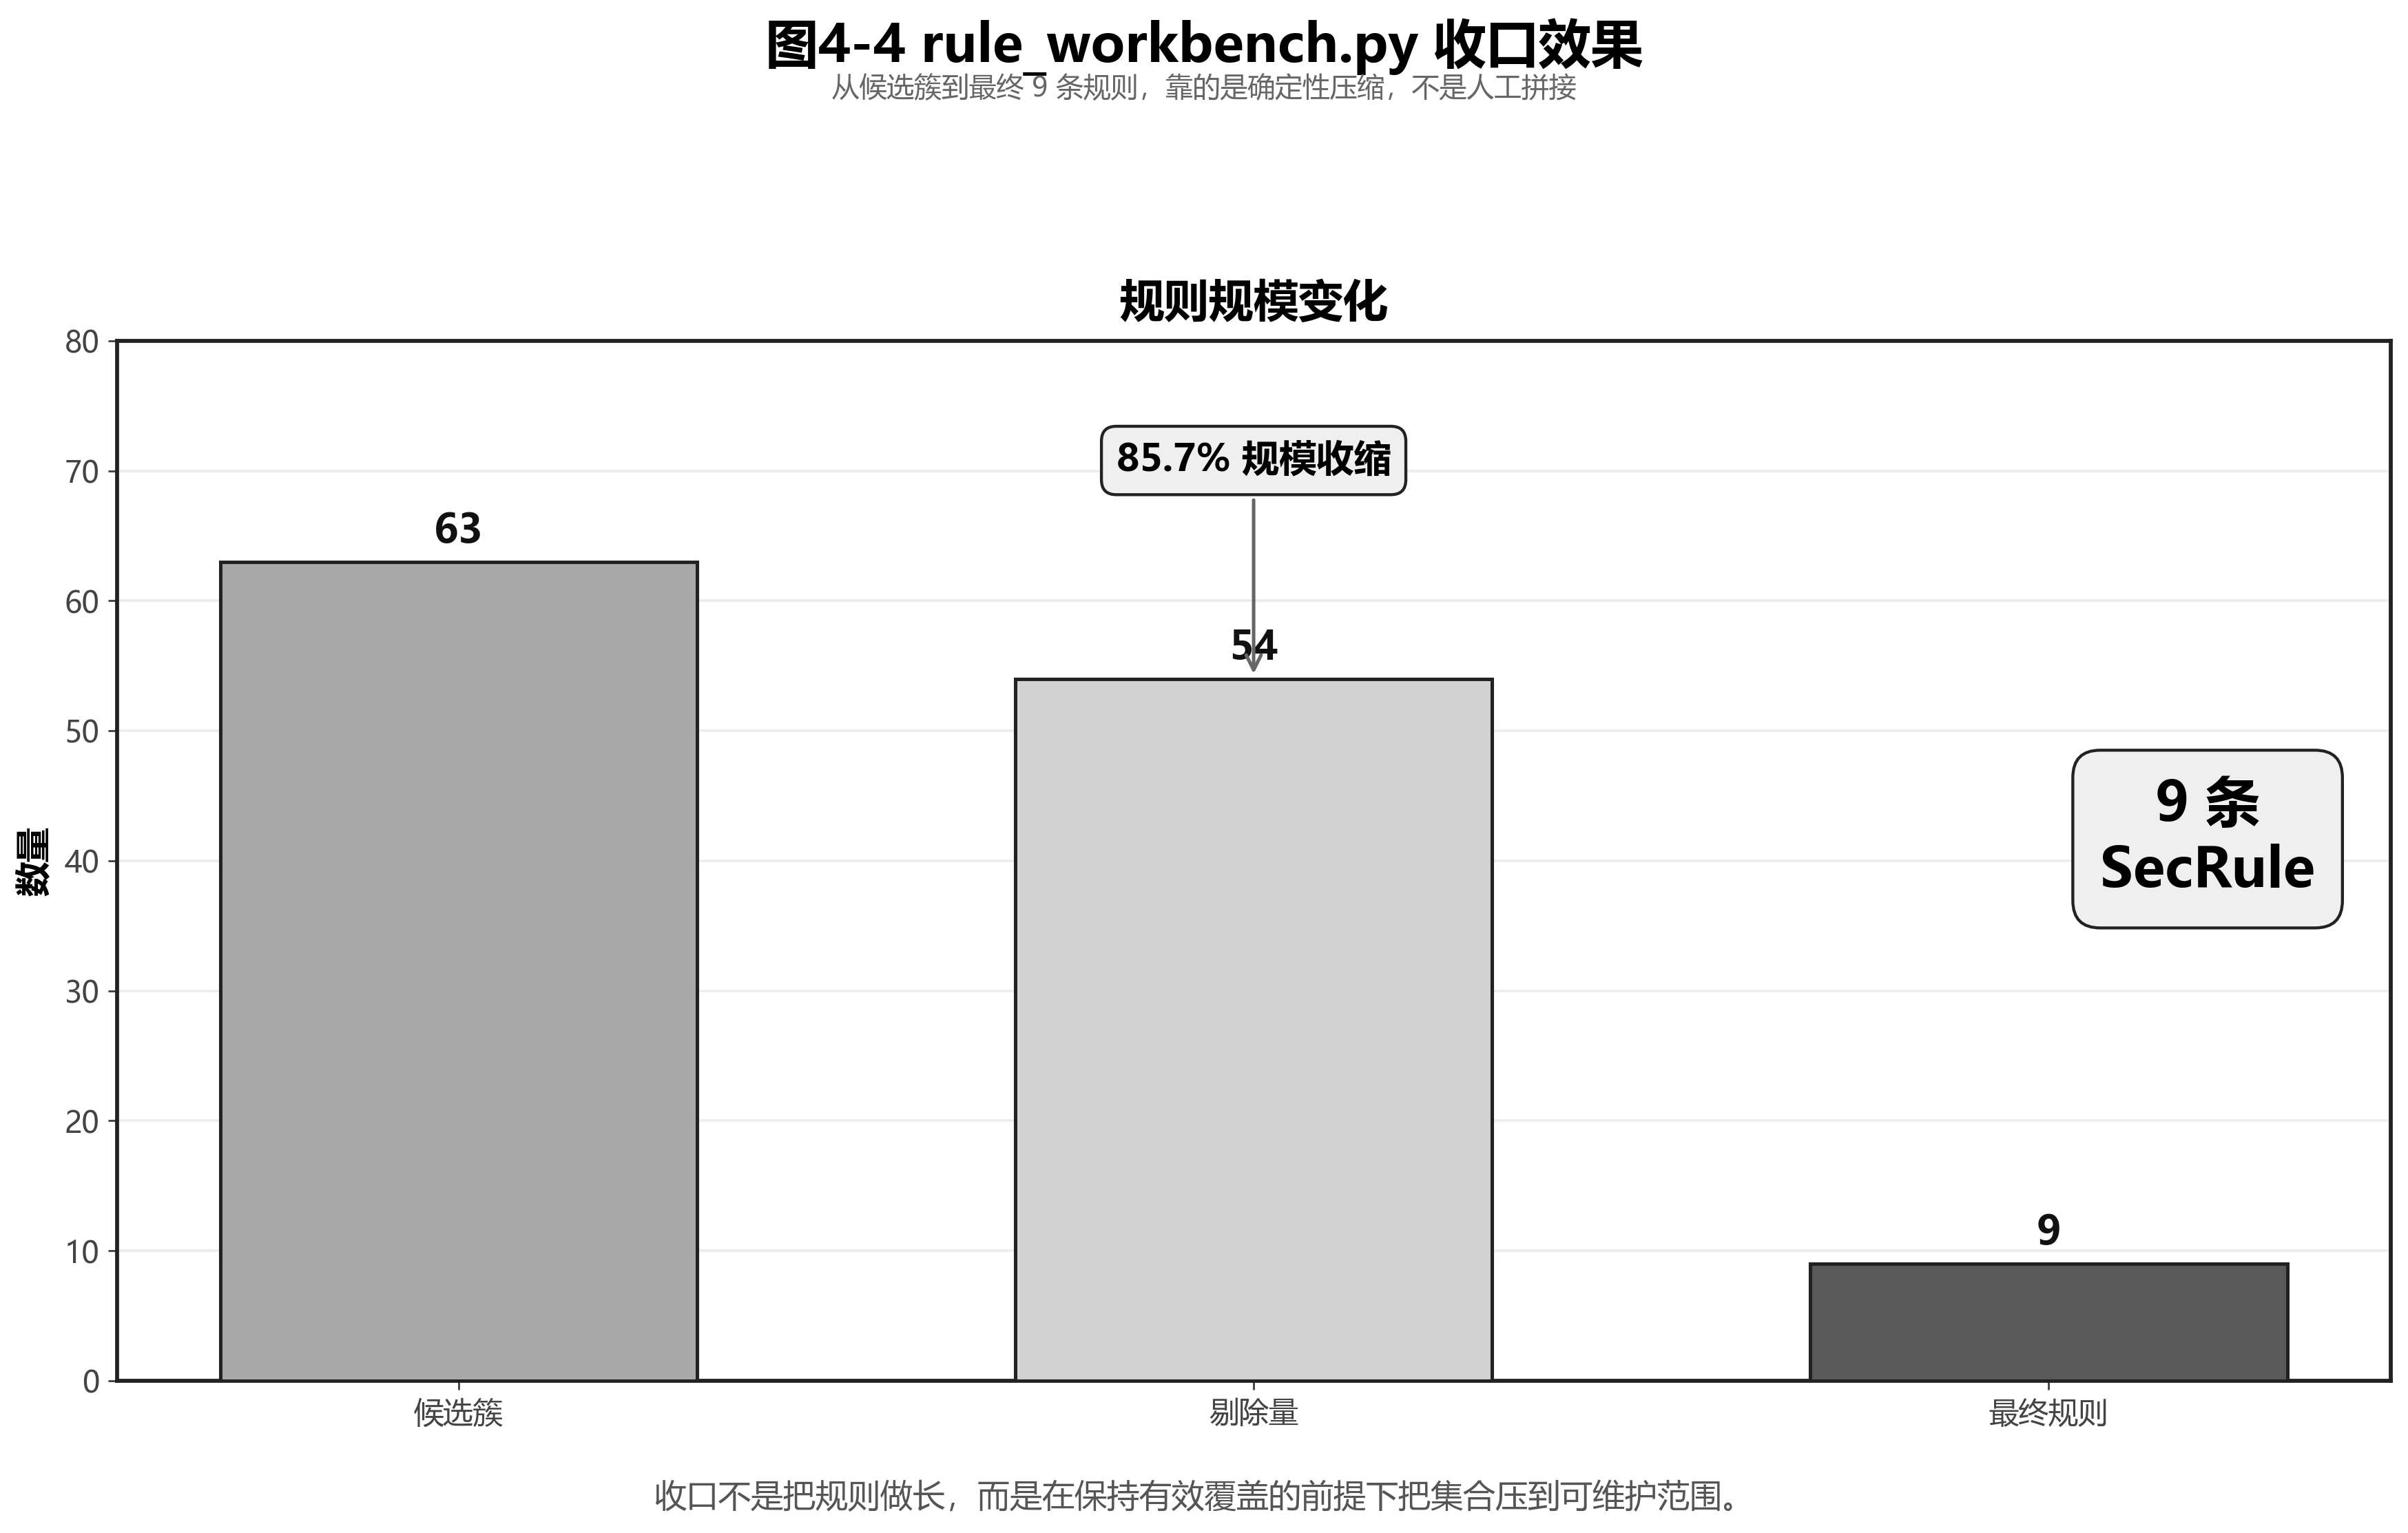
| 聚类—cluster_training_set.py: Token 化 → SBERT 向量化 → HDBSCAN 聚类,产出 63 个簇 + 206 条噪声
骨架提取—extract_cluster_patterns.py: 从每个簇提取候选正则骨架
规则投票—vote_cluster_regex.py:GPT 单模型三次采样投票,三次一致才进入候选集,得到15条
规则压缩—人工审核 + 消融对比: 从 15 条压缩至 11 条紧凑规则
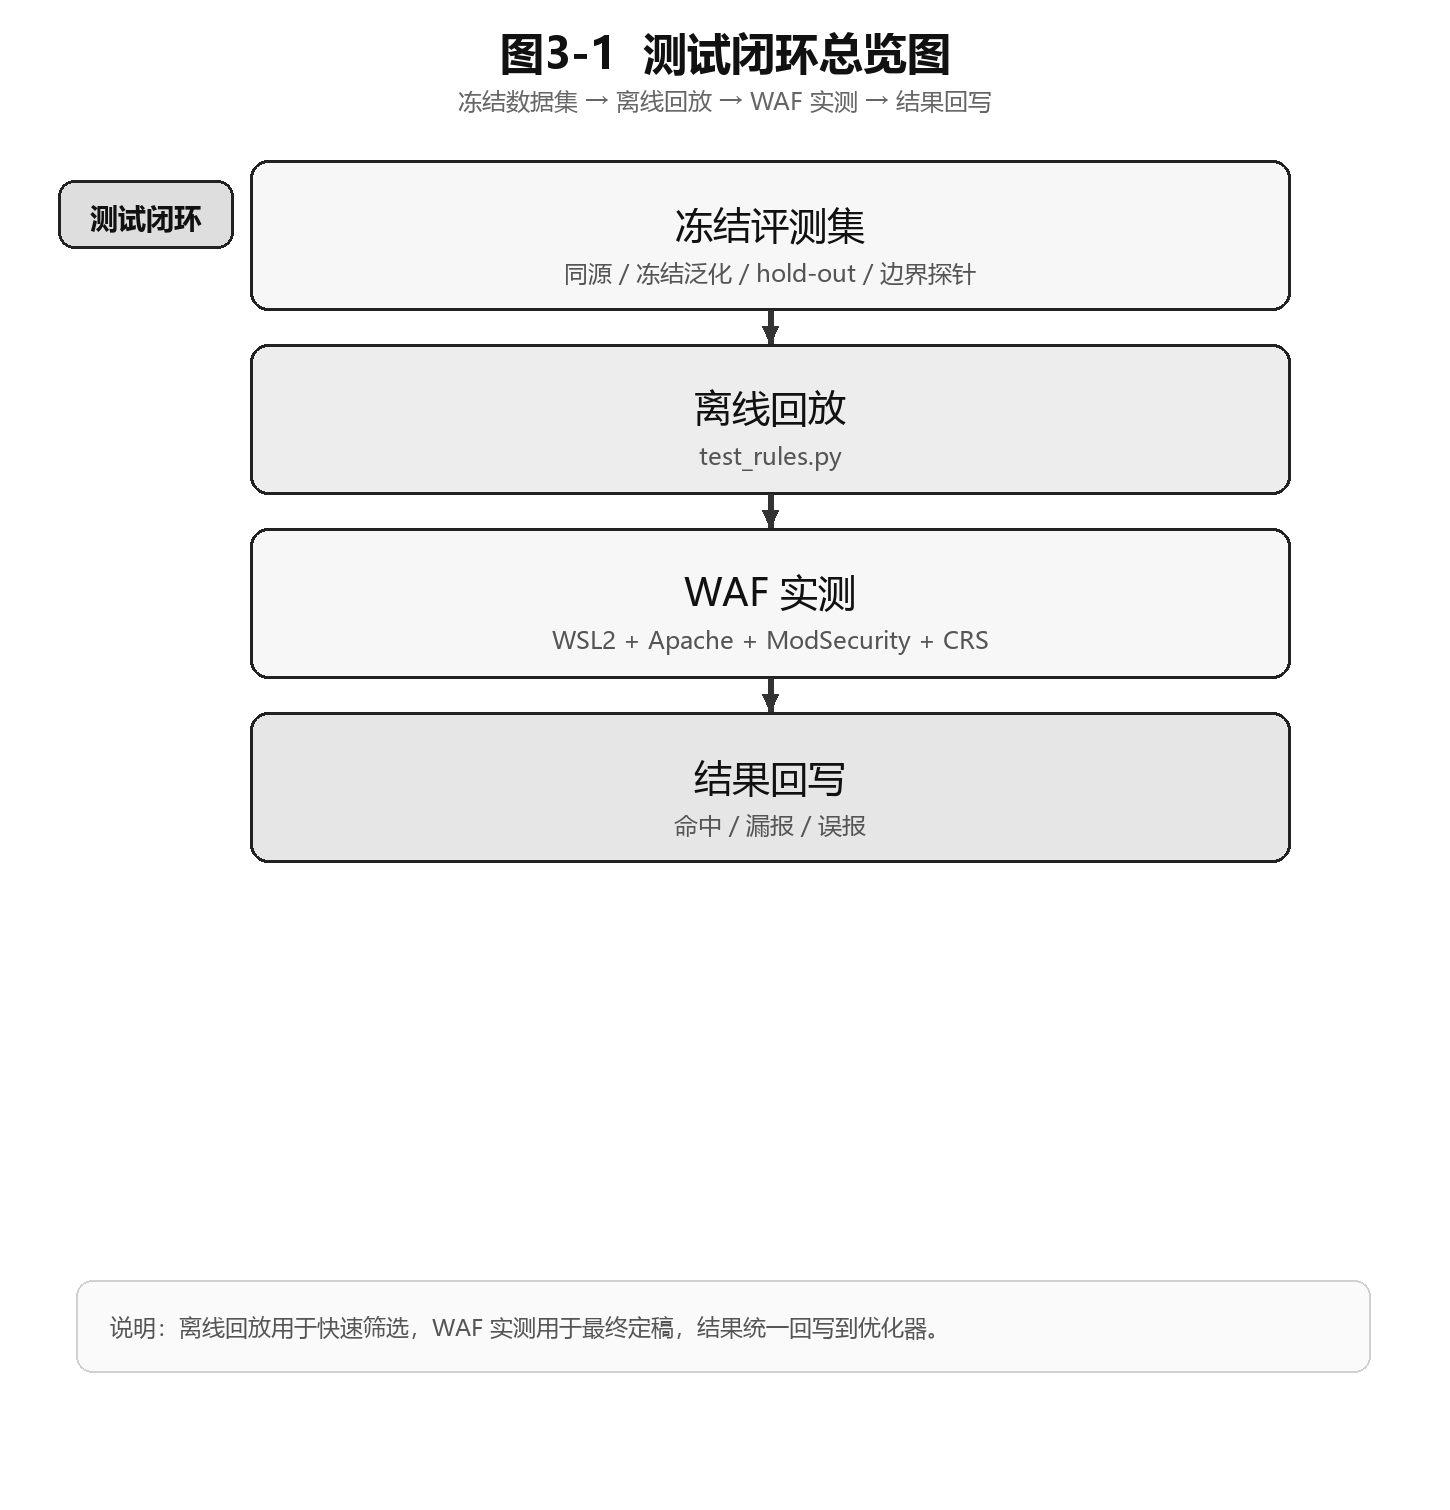
离线测试—test_rules.py:验证正则规则是否有效,统计命中/漏报/误报
评测集构建—build_*.py:(7 个脚本) 生成合法文本语境集、cat 语境探针、混合日志集、独立盲测集等
噪声审计—audit_noise_samples.py: 对 206
条噪声做五分类(类攻击,元数据,html碎片,文本)统计和人工抽样复核
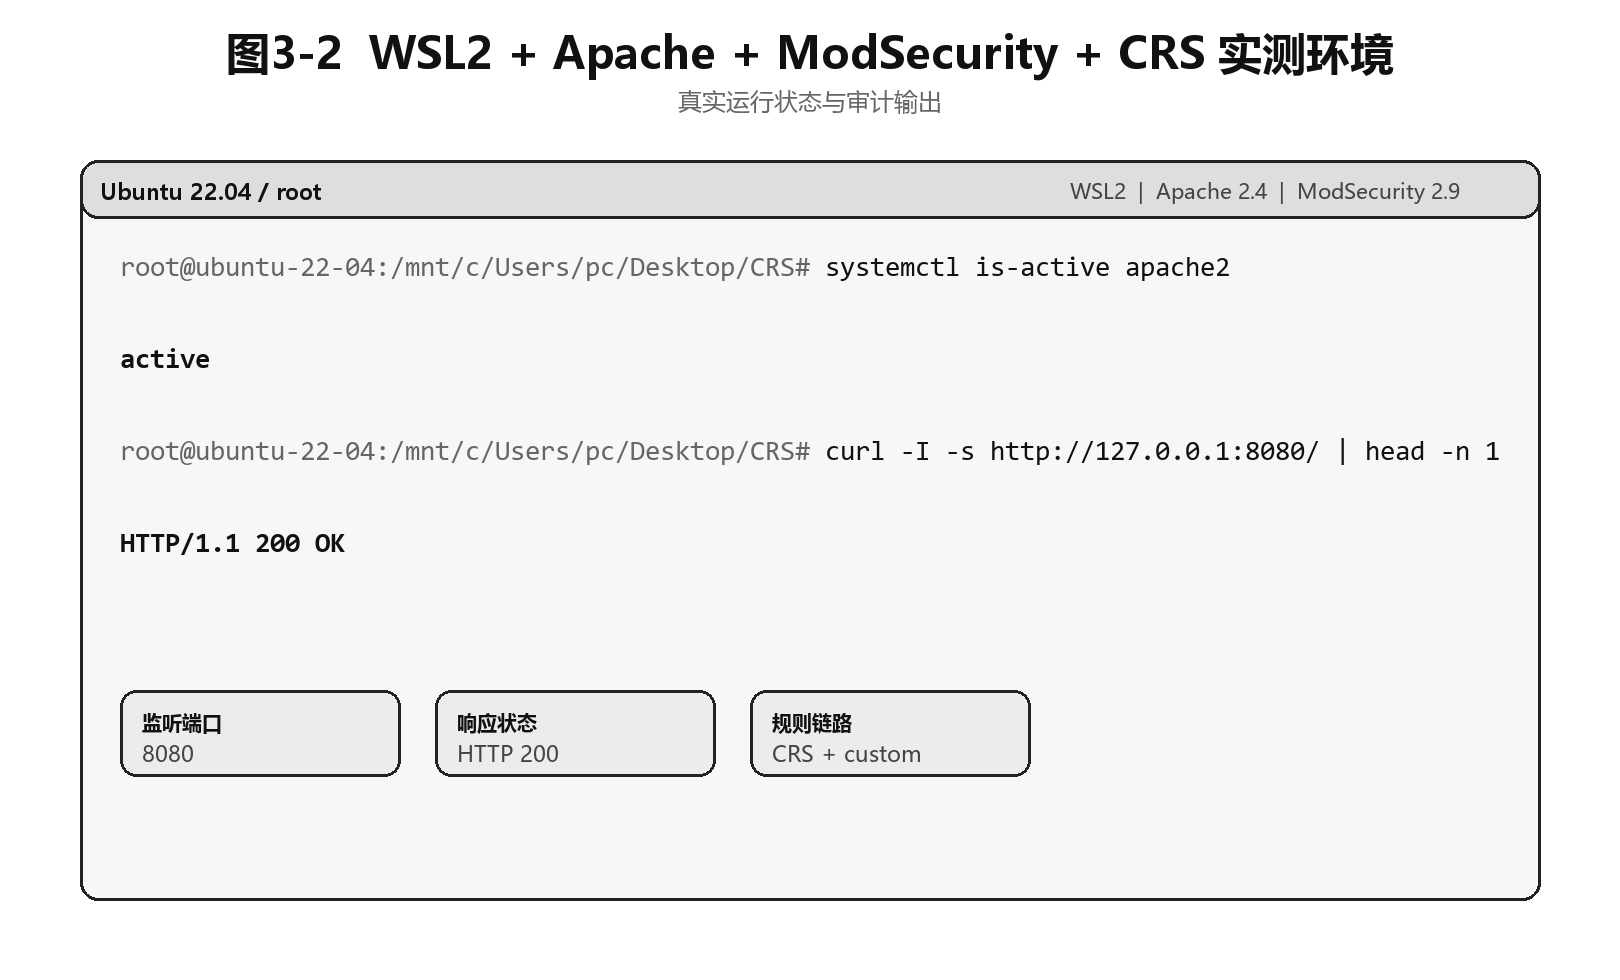
WAF 运行时—waf_probe.py: 在 WSL2 + Apache + ModSecurity + CRS 中实测拦截率
打包—CRSRuleMiner.spec:PyInstaller 打包成 exe,双击启动桌面工作台
3. 评测体系
同源测试—100 条:验证同分布覆盖能力
冻结泛化(离线)—149:离线正则回归测试
冻结泛化(WAF)—144 条:attack-only 真实 WAF 环境拦截率
独立盲测—64 条:验证对新来源的泛化能力
跨命令试点—80 条:验证对 wget/curl 的迁移能力
合法文本语境—110 条:测纯 prose 文本是否被误杀
cat 语境探针—117 条:测教程命令示例是否被误判
误报压力集—5000+5200+2037 条:真实日志大规模误报测试
custom-only 误报—500 条:剥离 CRS 其他规则后的纯净误报测试
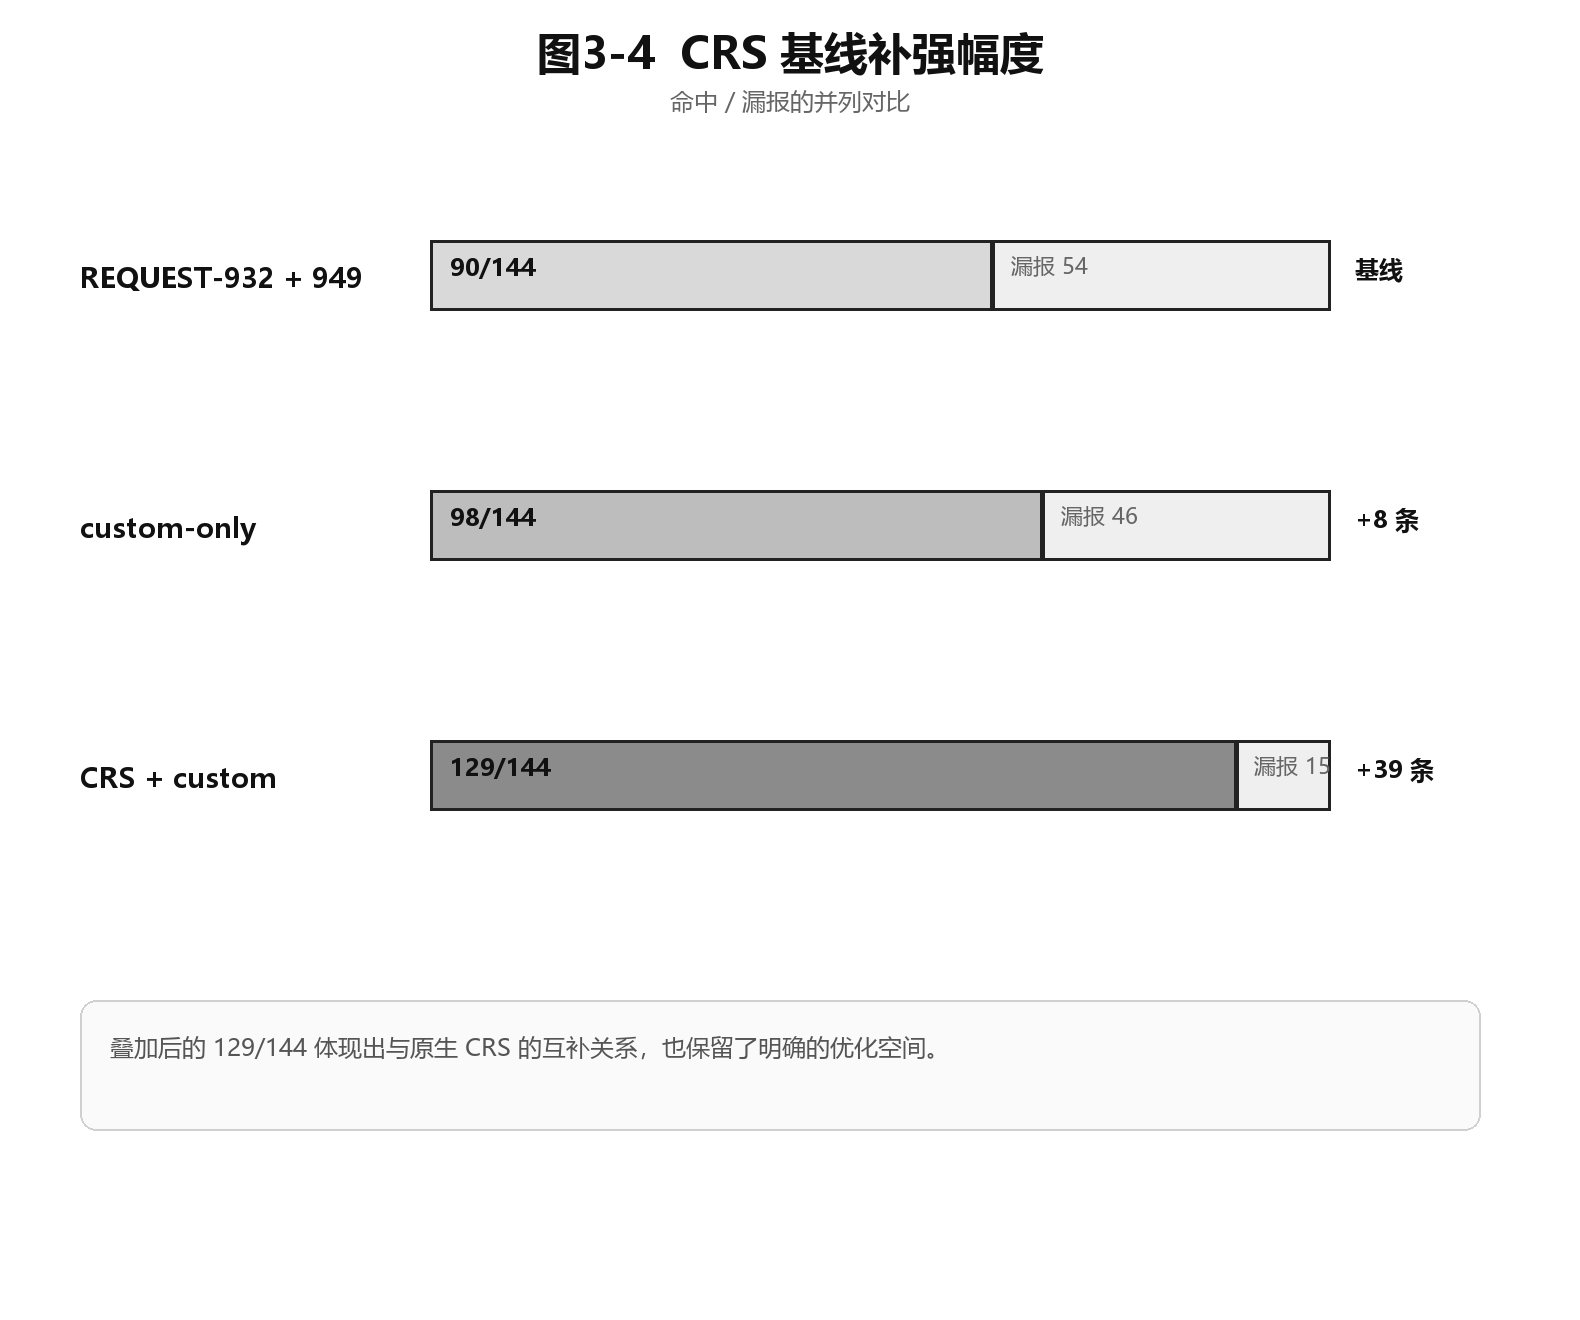
CRS 932 剥离—90/144 vs 129/144:量化自定义规则的净增量
四:核心代码
1. 自研变种(generate_variants.py)
主要作用:
围绕 10 种维度生成变种:变量插入、大小写混淆、完整路径替换、IFS及其变种替代、路径斜杠变种、通配
符变种、引号拆分、变量拼接、二层组合、三层组合。每条原始 payload 随机选取 4-5 种适用规则生成变种,
主要库为:
random打乱顺序,随机选取,re定位cat位置,pathlib读写输入输出文件等...
Seed=20260611。
举例空格变种函数:
应用顺序:
尝试次数:
运行变种脚本,在165条真实数据的基础上生成737条变种数据
2. 聚类(cluster_training_set.py)
主要作用:
聚类函数分为三步:
将训练集中的 payload 按 shell 元字符(特殊符号)切分为 token,用 all-MiniLM-L6-v2 编码为 384
维语义向量,再通过 HDBSCAN 密度聚类自动发现簇,并输出簇结果和噪声列表。
|
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
| 主要库为:
re 按 shell 元字符正则分词,sentence-transformers 将 token 序列编码为语义向量,hdbscan 密度聚类,numpy
承载嵌入矩阵,json 输出聚类结果,argparse 解析命令行参数,pathlib 读写文件。
分词正则+Token化:
all-MiniLM-L6-v2 编码Token化的payload为 384 维语义向量:
(解决SSL证书问题:从 Hugging Face
下载模型时,系统要验证SSL证书,但容易验证失败,所以绕过验证,强制信任服务器)
聚类函数:
其中调入两个关键HDBSCAN参数,min_cluster_size=5表示一个簇至少5个成员,min_sample=k(1)
(k值,表示以一个点周围有k个点来判断他是否可以成为中心,k=1这里就会让聚类很敏感,不易把边缘样
本当成噪声处理掉)
聚类结果:
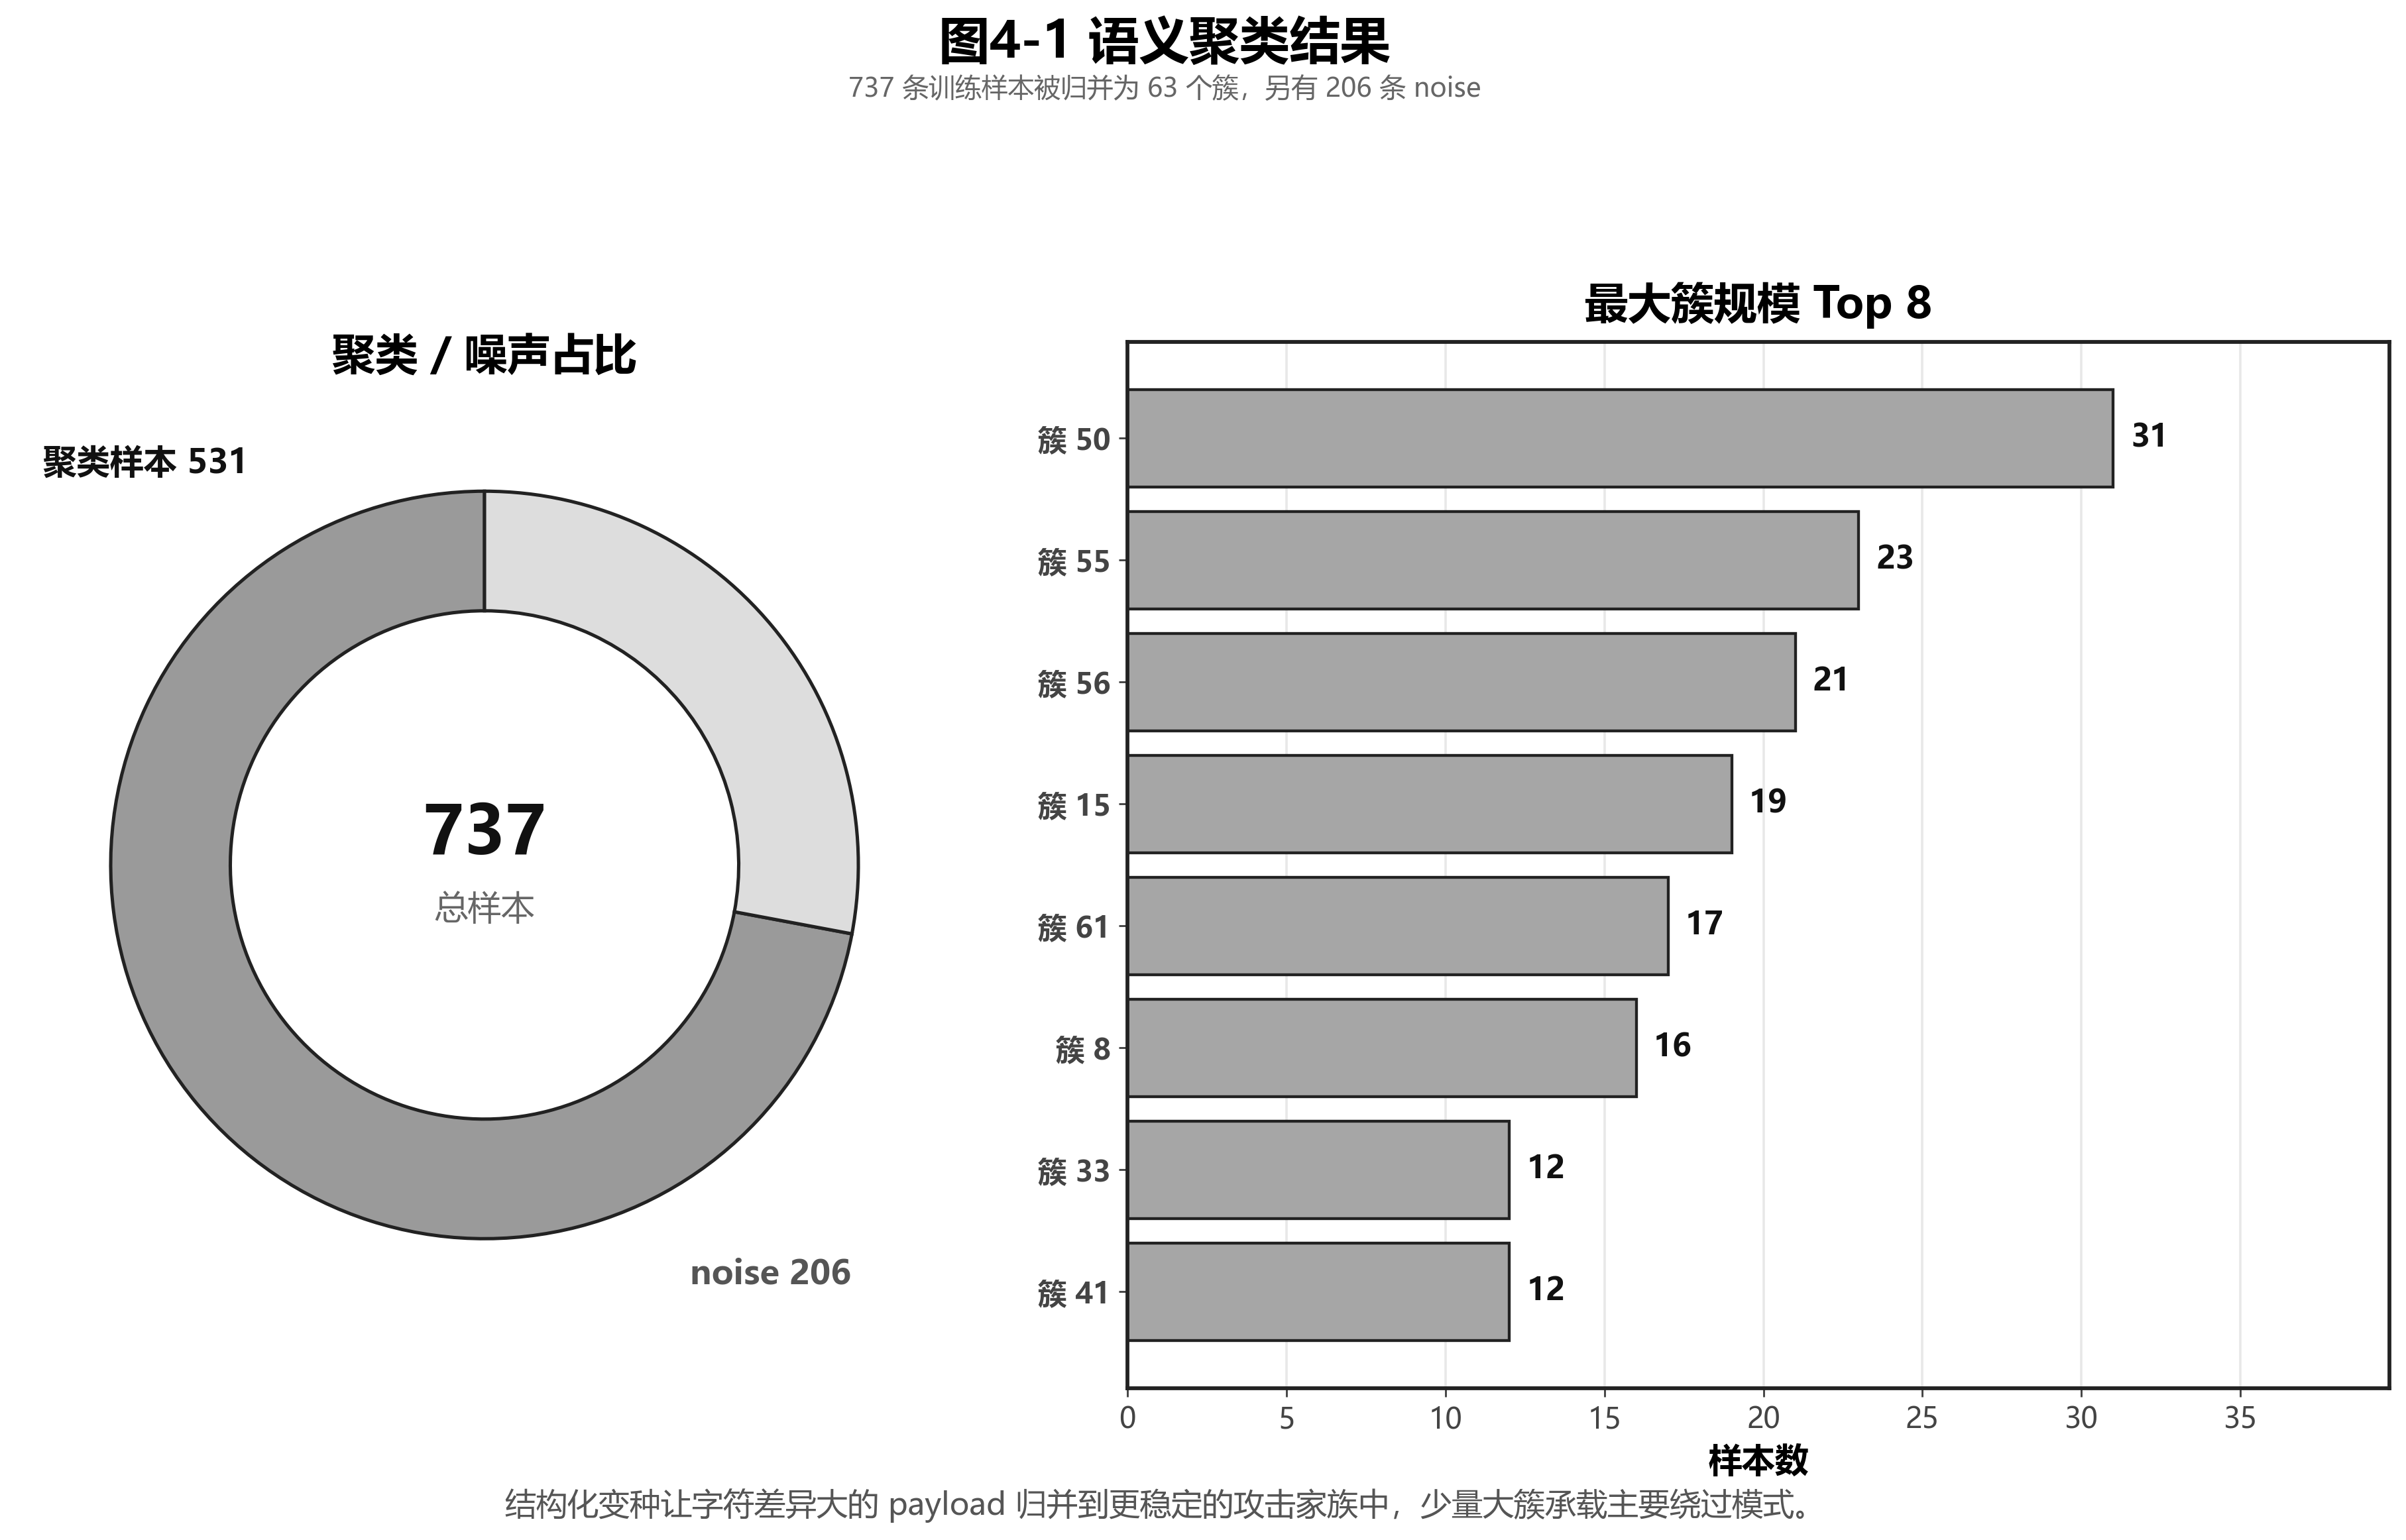
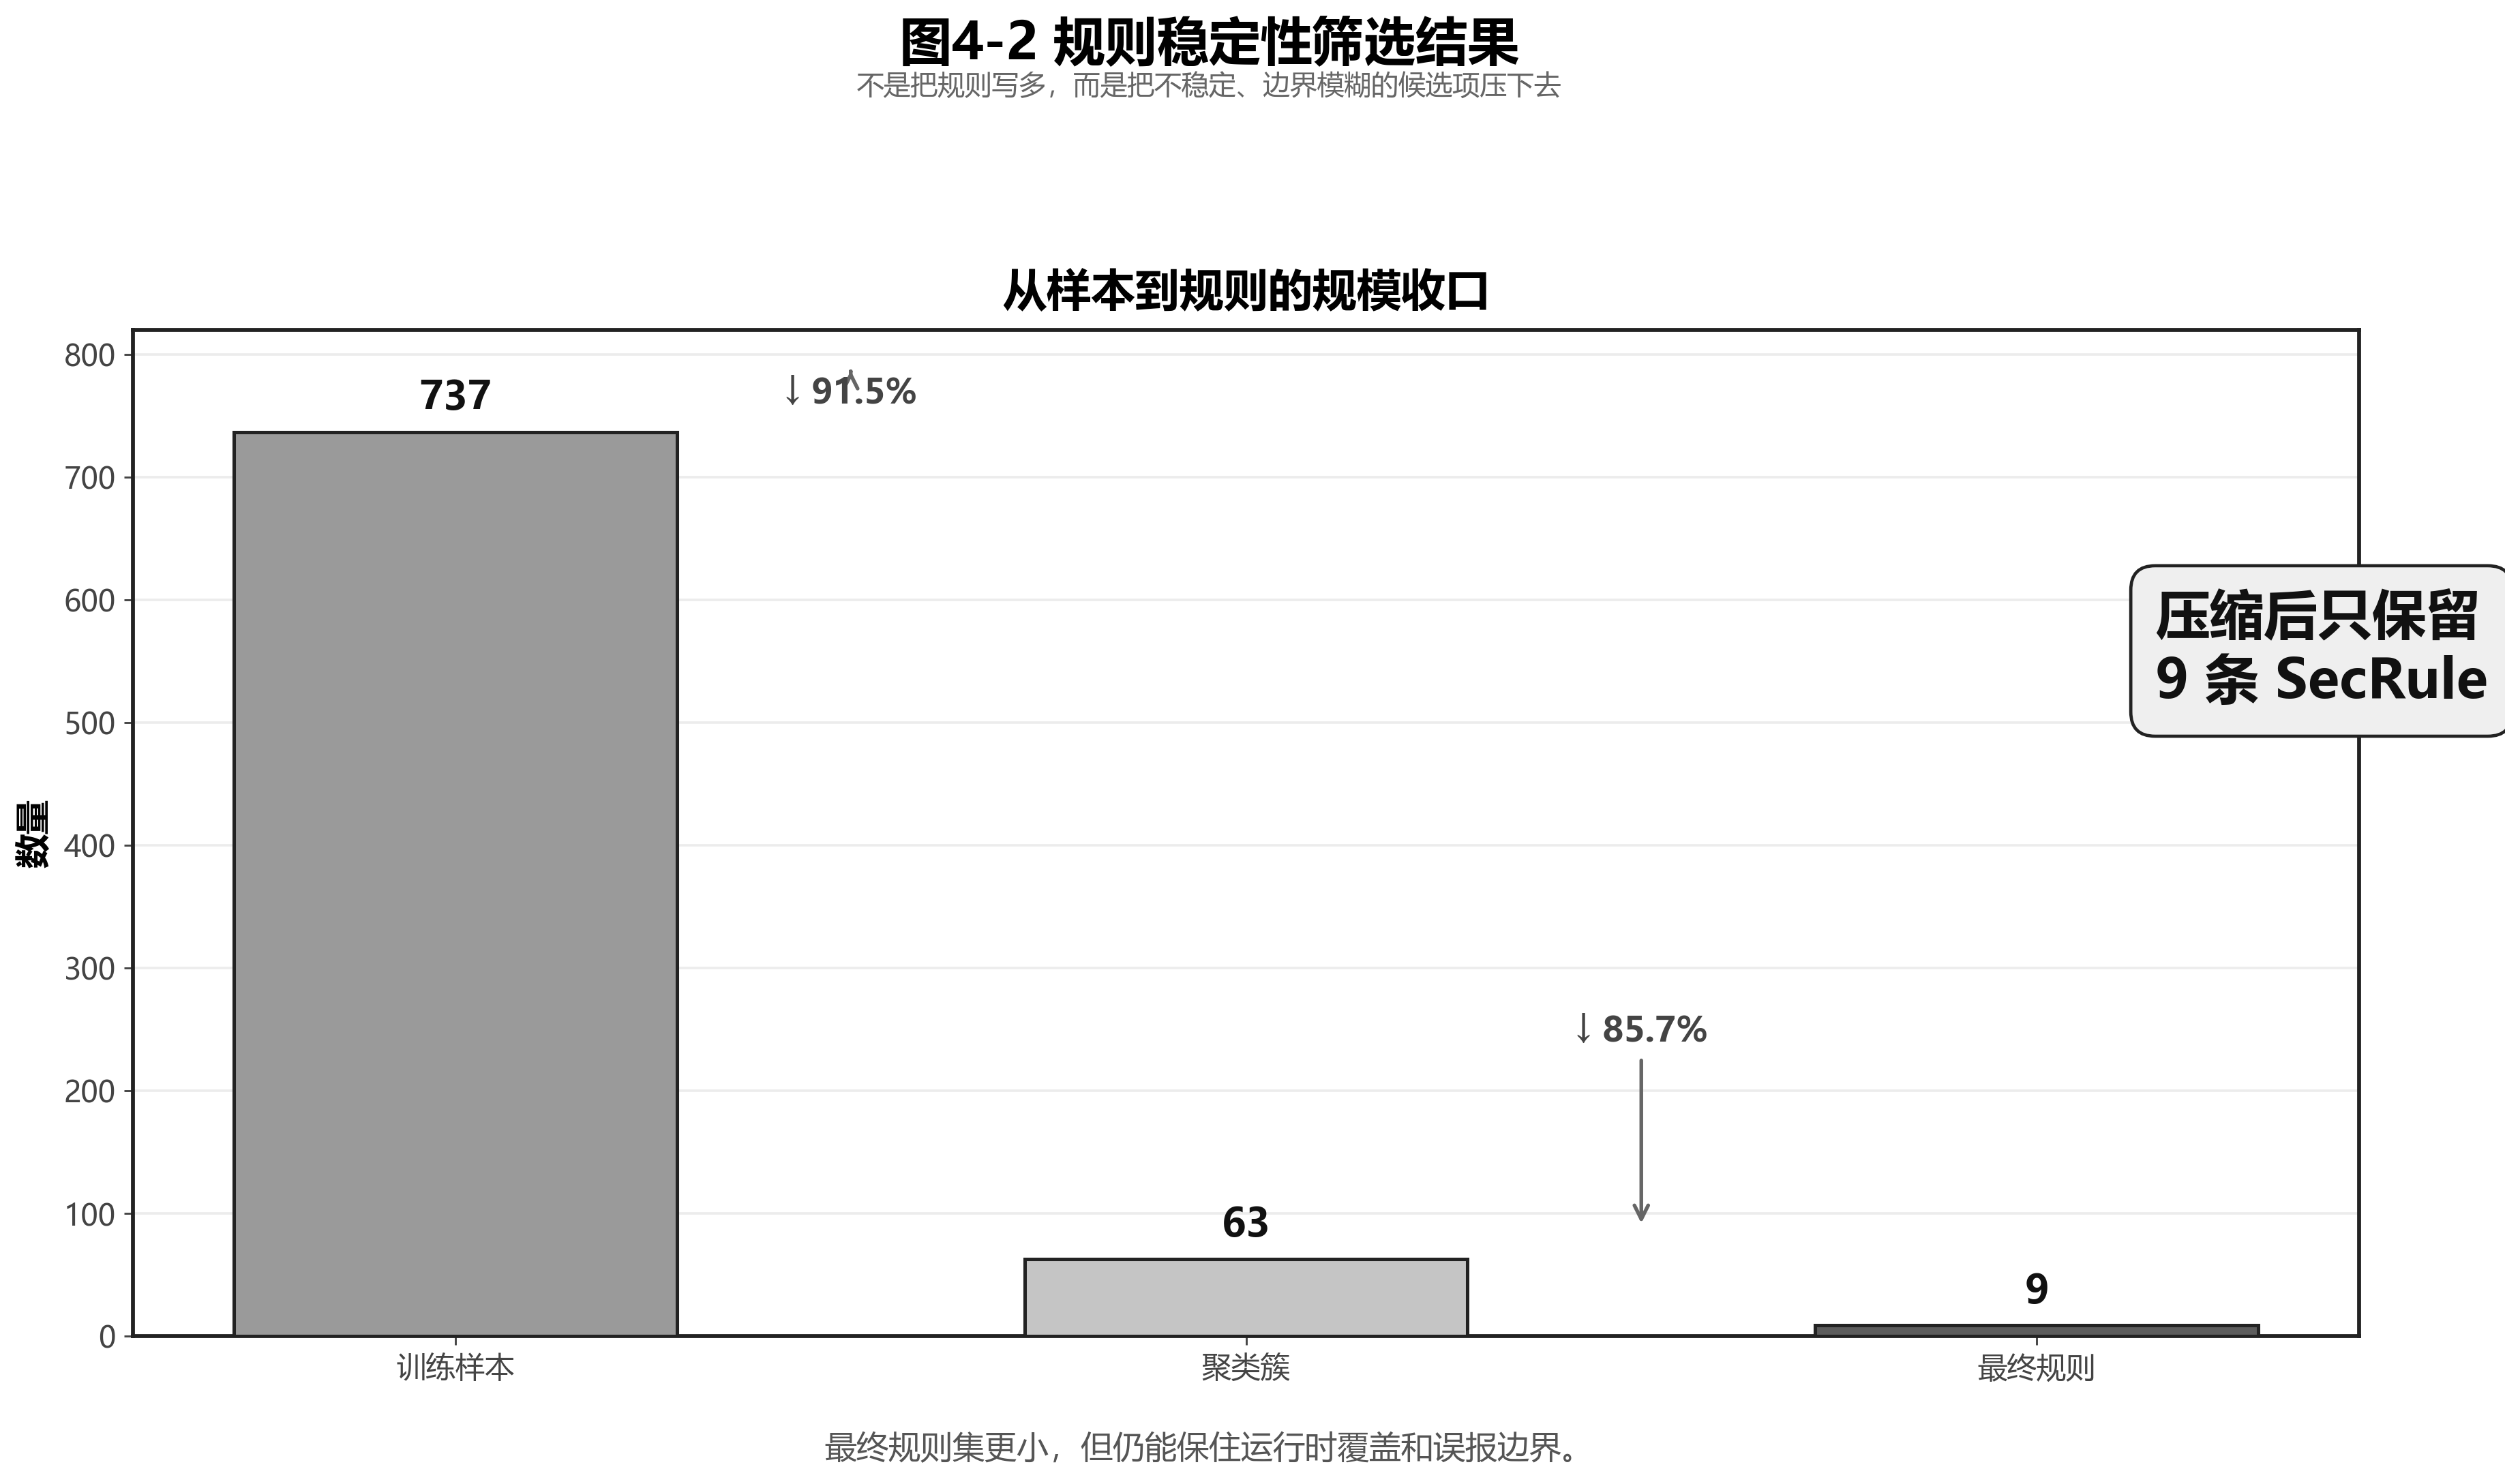
737 样本 → 63 簇 + 206 噪声,噪声率 27.95%,轮廓系数 0.4549,输出cluster_results.json,记录
3. 规则投票(vote_cluster_regex.py)
主要作用:
对每个簇,将簇内 payload 样本发送给 LLM,独立调用 3
次gpt5.5(temperature=0.7),要求每次归纳一条正则表达式。仅当 3
次输出完全一致时,该候选规则才被接受;不一致的簇标记为投票分歧,暂不收录。
主要库为:
openai 调用 GPT 接口生成规则,httpx 自定义 HTTP 客户端(禁用 SSL 验证、支持自定义 base_url),json
读写聚类结果和投票输出,re 清理 LLM 输出中的 markdown 标记,os 读取环境变量中的 API Key,time
指数退避重试,argparse 解析命令行参数。
调用模型以及参数:
My Prompt::
投票逻辑:
调用+异常重试:
调用 GPT 拿正则,失败了自动重试最多 3
次,每次间隔越来越长(1秒→2秒→4秒),三次全失败就抛异常。
4. WAF 运行时验证(waf_probe.py)
主要作用:
向本地 WSL2 中运行的 Apache + ModSecurity + CRS 发送真实 HTTP 请求,逐条携带攻击
payload,根据返回的 HTTP 状态码判断是否被 WAF 拦截(4xx/5xx 视为拦截,2xx/3xx 视为放行),统计
blocked/allowed 数量
主要库为:
urllib.request 发送 HTTP GET 请求,urllib.parse 将 payload 编码为 URL 查询参数,sys 读取命令行传入的目标
URL 和 payload 文件路径。
请求构造:
拦截判定逻辑:
运行方式:
python waf_probe.py http://127.0.0.1:8080 locked_generalization_attack_real.txt
|
实验结果与打包
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
| 输出示例:
URL: http://127.0.0.1:8080
Total: 144
Blocked: 129
Allowed: 15
Allowed samples:
- line 26: [200] cat%20/et%5C%0Ac/pa%5C%0Asswd
五:实验结果
1. 聚类阶段
输入样本:737
聚类数:63
噪声点:206
轮廓系数:0.454909
噪声抽审结果:人为观察206 个
噪声里,符号混淆的—153个、像真命令的—40个,html标签—9个、普通文本—4
观察噪声得到结论:206 条噪声里,只有 13 条是真正的废物。所以噪声不能直接扔,值得人工少选
2. 规则投票阶段
模型:gpt-5.5
Temperature:0.7
每簇采样:3 次
处理簇数:63
一致通过簇数:0
一致拒绝簇数:63
也就是说,三次采样投票没有直接产出“完全一致”的簇级规则,后面还是靠人工筛选和压缩落地。
说明!LLM在随机性不同的时候,无法自动的产出稳定的规则!
3. 规则压缩对比
对比 rules_final.txt(15条) 和 rules_final_compact.txt(11条):
评测集
测什么
15 条
11 条
变化
同源集(100条)
训练分布内的变种
91/100
100/100
从差9个到全过
冻结泛化攻击子集(144条)
真实攻击
139/144
144/144
从差5个到全过
独立盲测(64条)
全新来源
62/64
62/64
无变化
结论:
11 条紧凑规则比 15 条更稳;
4. 冻结一次、只测一次的公共来源 hold-out
公共来源hold-out(64条)和训练链路完全无关,是 6
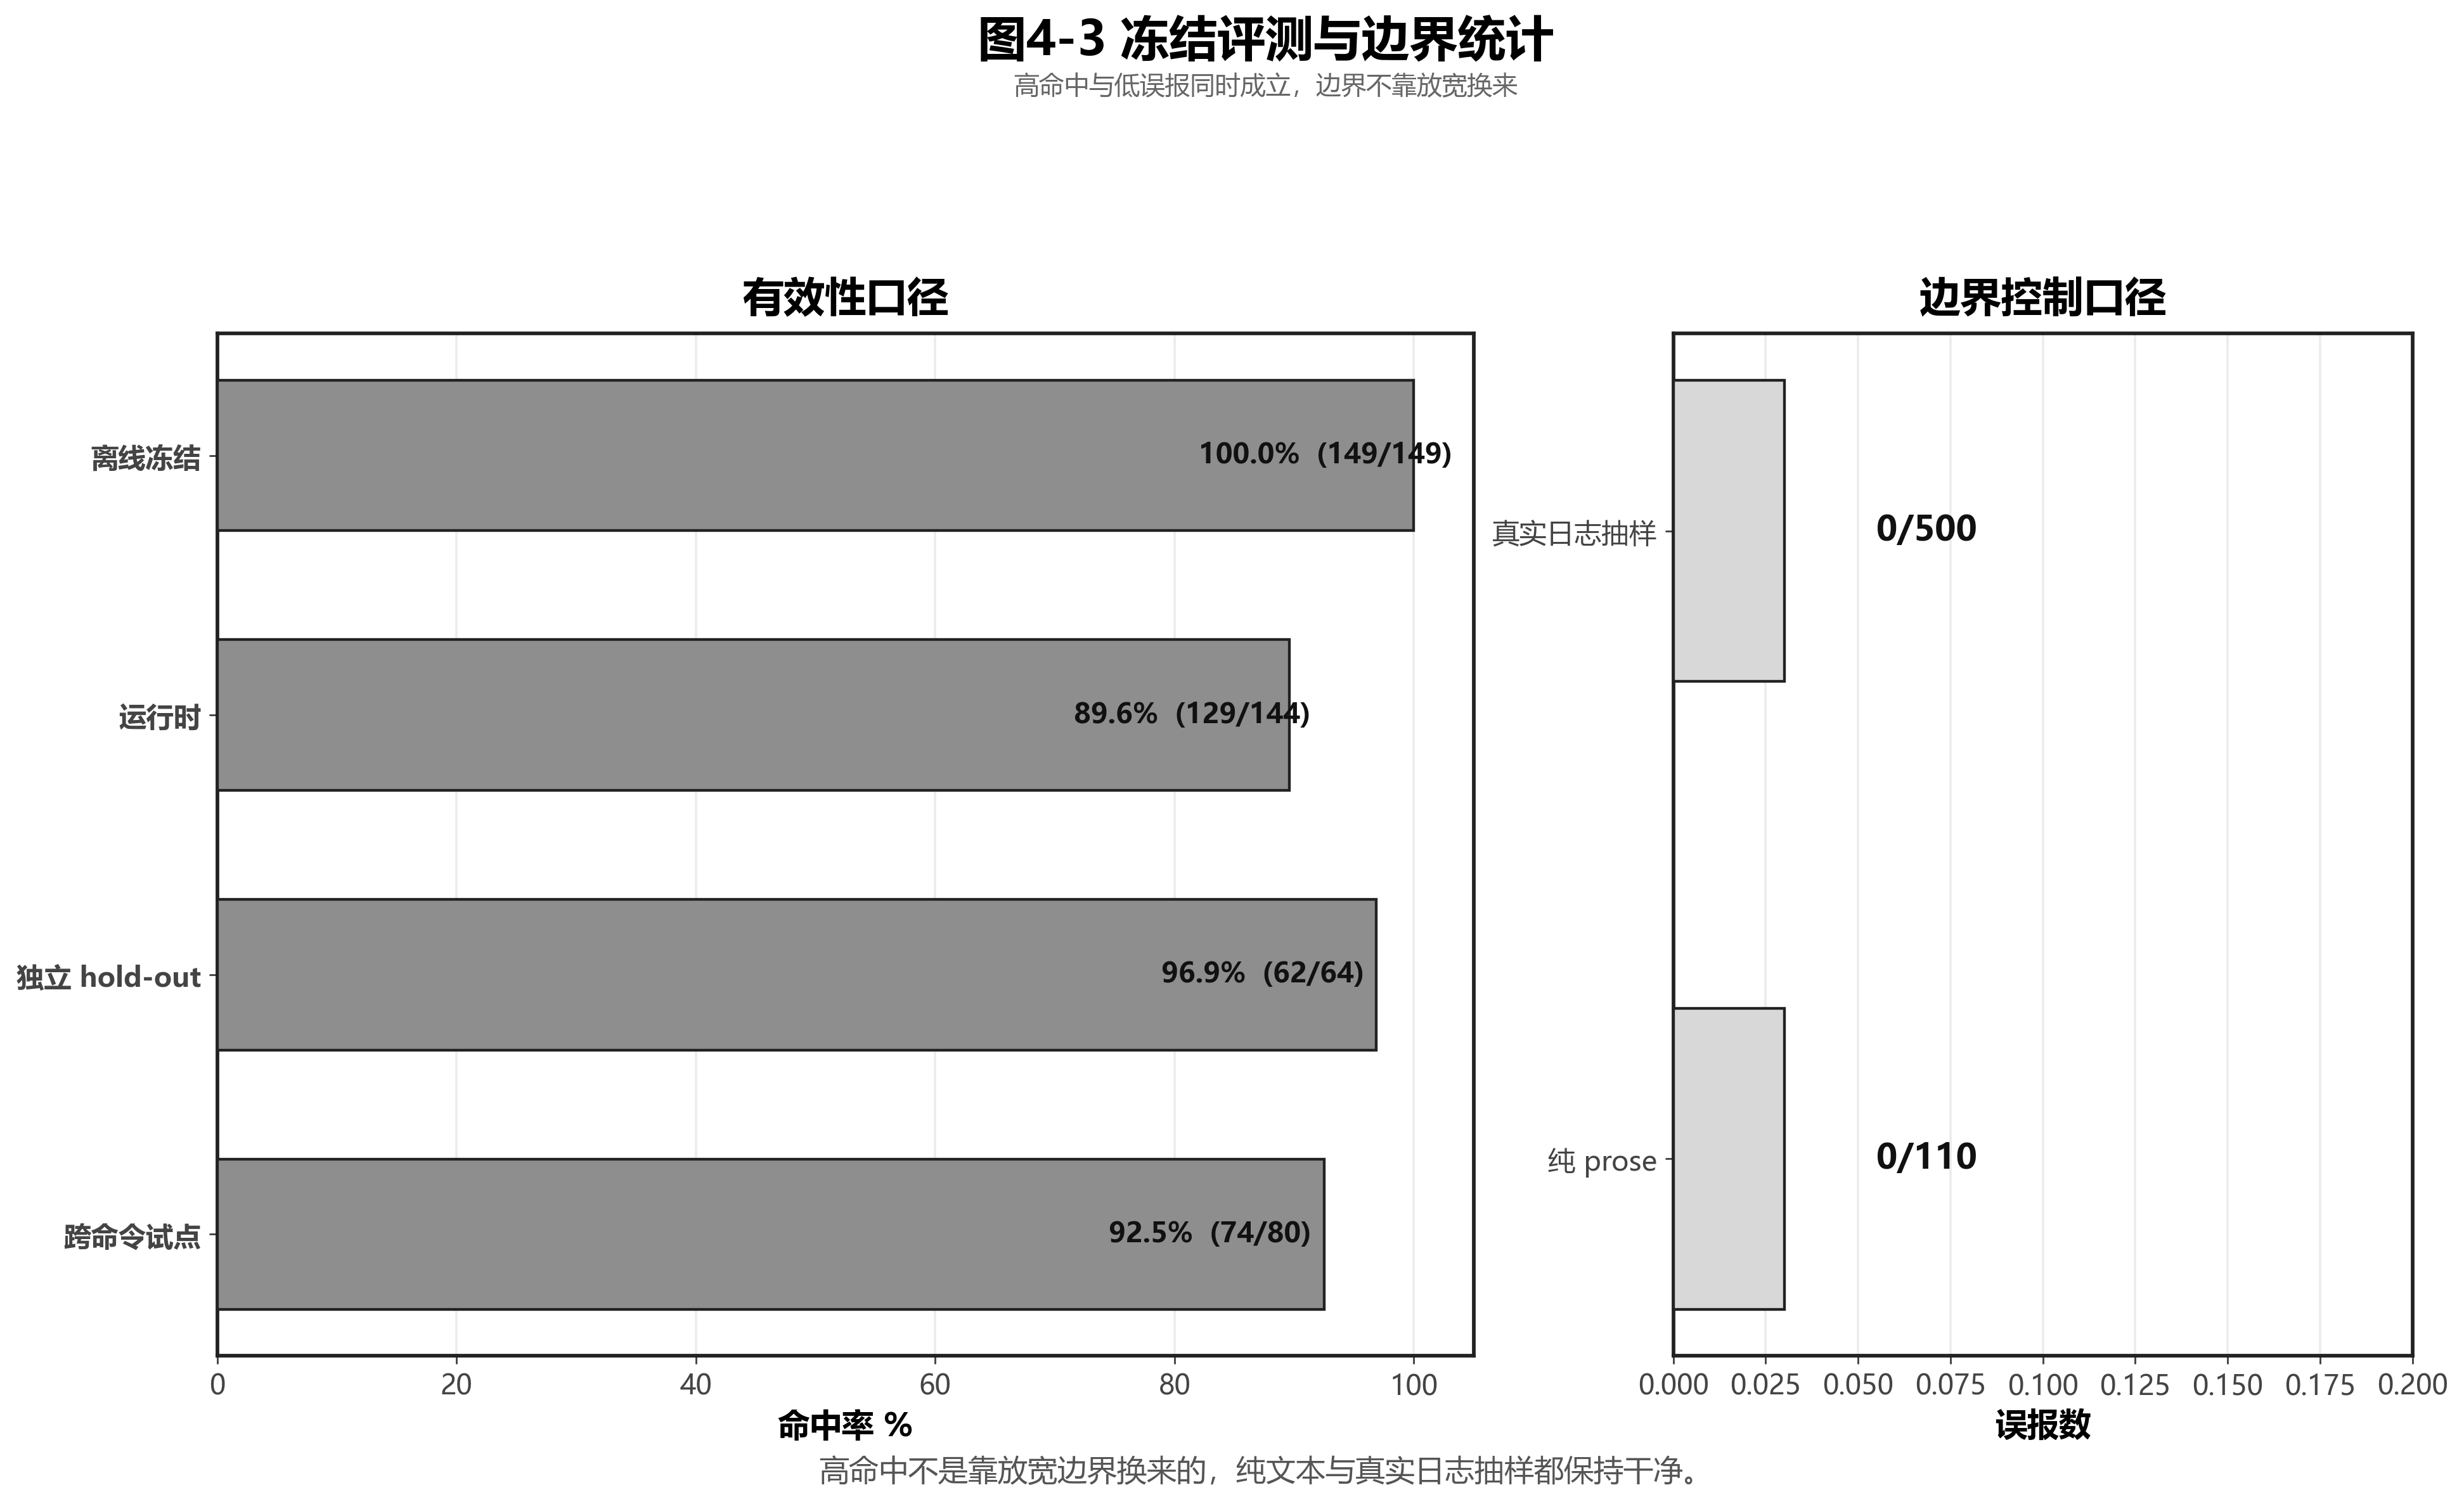
个新来源的独立样本。冻结后只测一次,也不再回头调参。这组 63/64 是整个项目里最接近独立盲测的证据
|
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
68
69
70
71
72
73
74
75
76
77
| ,说明规则不是靠记住训练数据得分,而是真正学到了绕过家族的通用模式。
来自frozen_independent_blind_result.json) 的结果:
64 条,63 条命中,1 条漏报,命中率 98.44%
漏掉的那条是:
cat%20/et%5C%0Ac/pa%5C%0Asswd
5. 误报与边界测试
纯误报集(一点不能报错):
benign_context_docs.txt
110
条
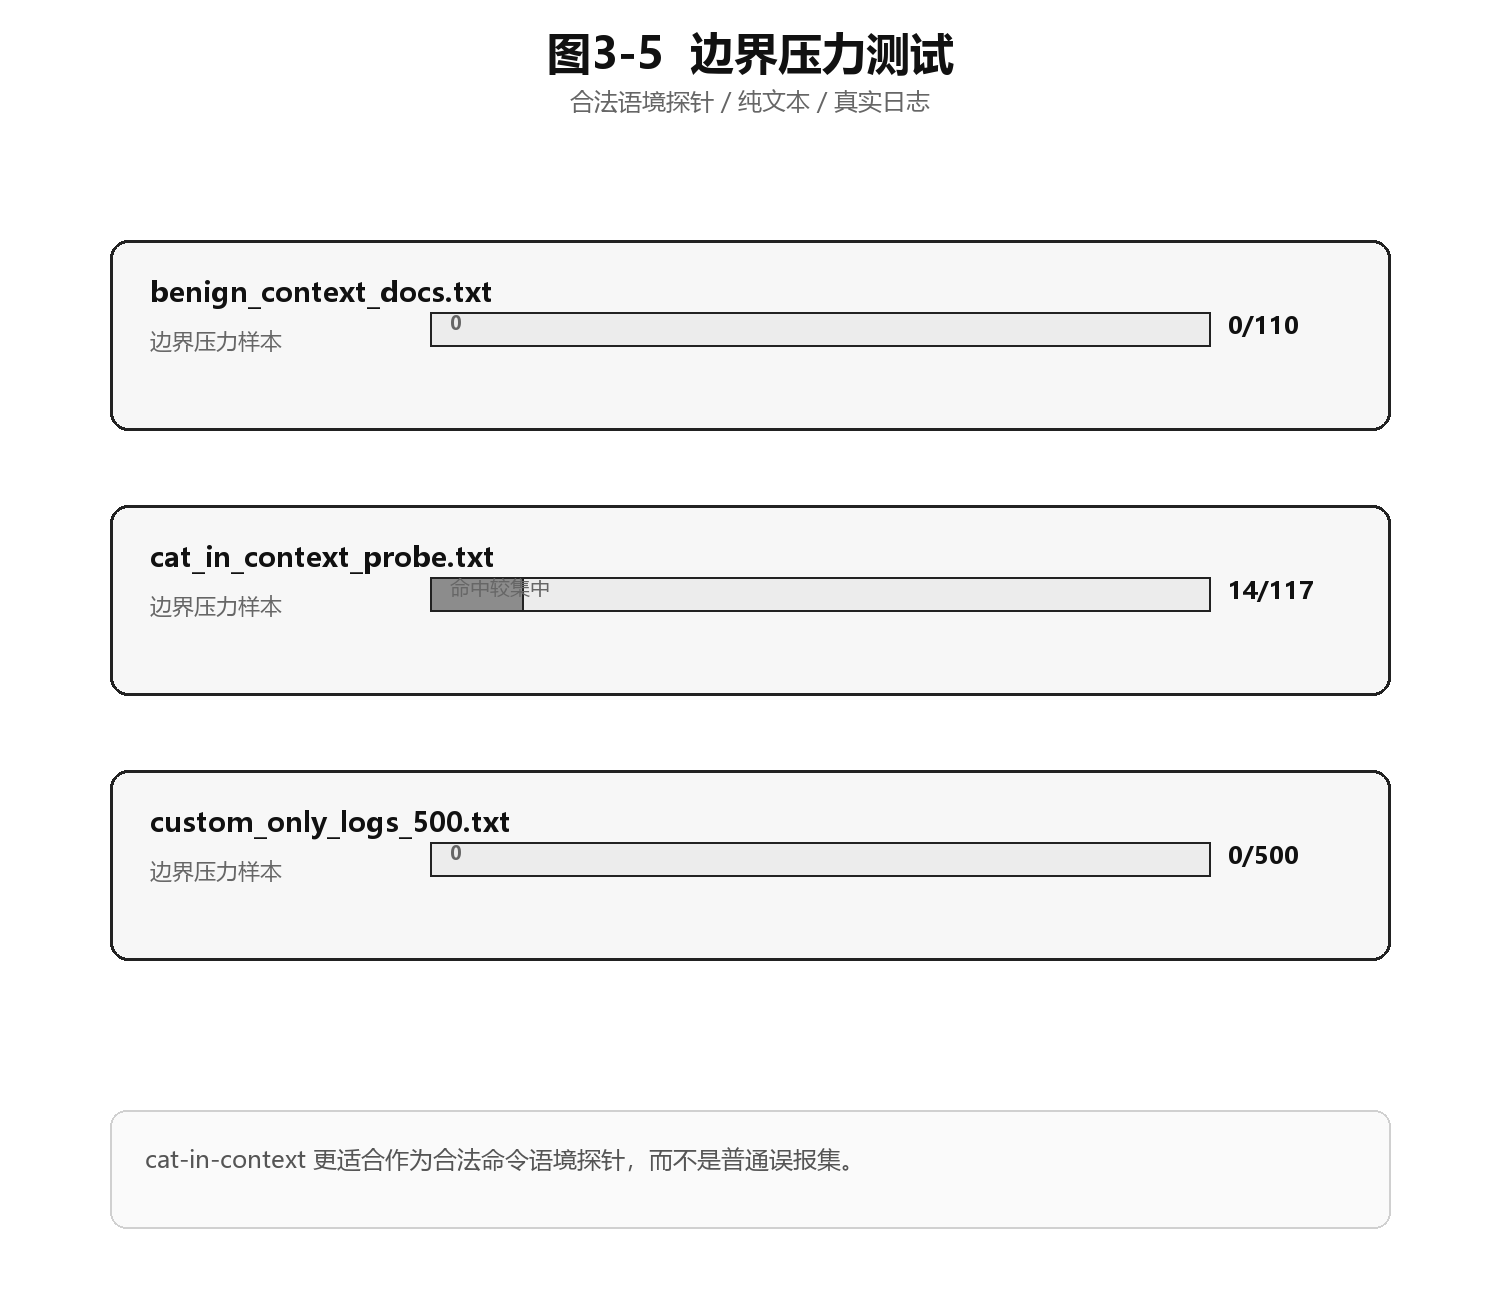
纯文字文章文档,
教程、说明书
0
误
报
规则完全不碰纯文字
custom_only_logs_500.txt
500
条
混合日志抽样,只
测结论规则
0
误
报
剥离 CRS 其他规则后的纯净结果
false_positive_logs_stress.txt
5200
条
真实访问日志压力
集
0
误
报
15 条版本曾误拦 200 条,11 条压到
0,体现了压缩效果
边界探针集:
(来源于: man7.org 的 CAT(1) 手册页格式、FreeCodeCamp 的教学风格、GeeksforGeeks 的结构化示例等...)
cat_cat_in_context_probe.txt
117
条
Cat攻击payload
117条拦住了1
15个
15 条版本曾误拦 200 条,11 条压到
0,体现了压缩效果
说明规则对命令模式高度敏感
6. CRS 运行时对比
C:\Users\pc\Desktop\coreruleset\rules\REQUEST-932-APPLICATION-ATTACK-RCE.conf
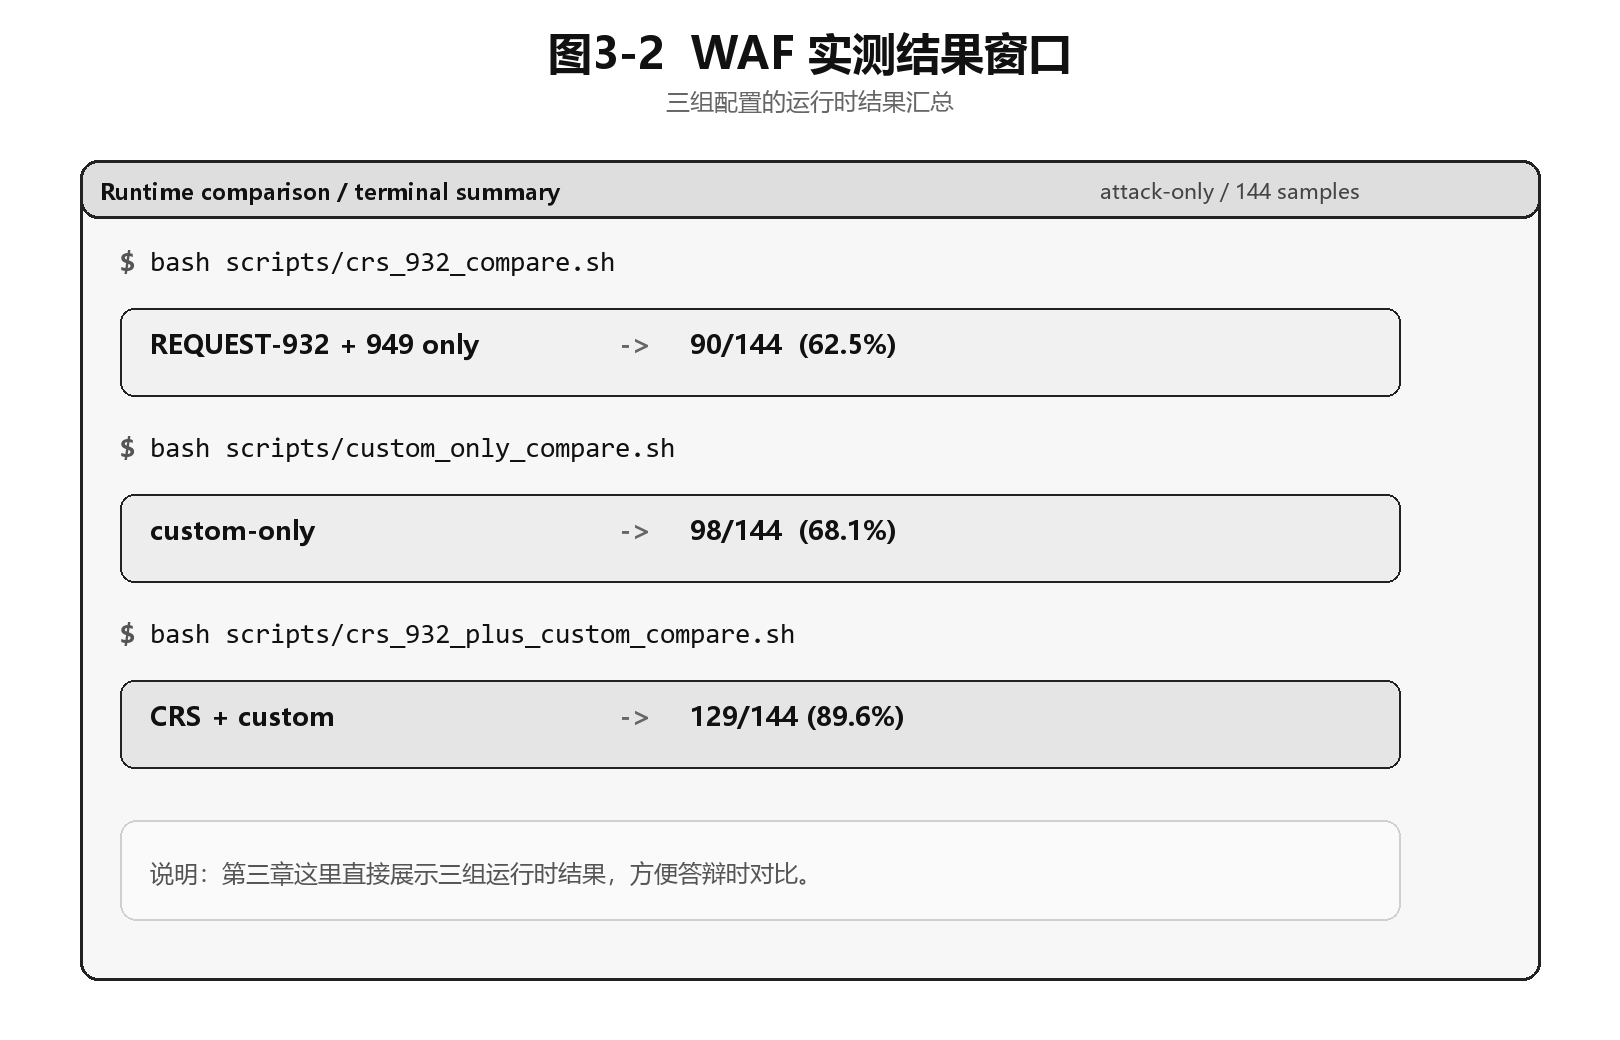
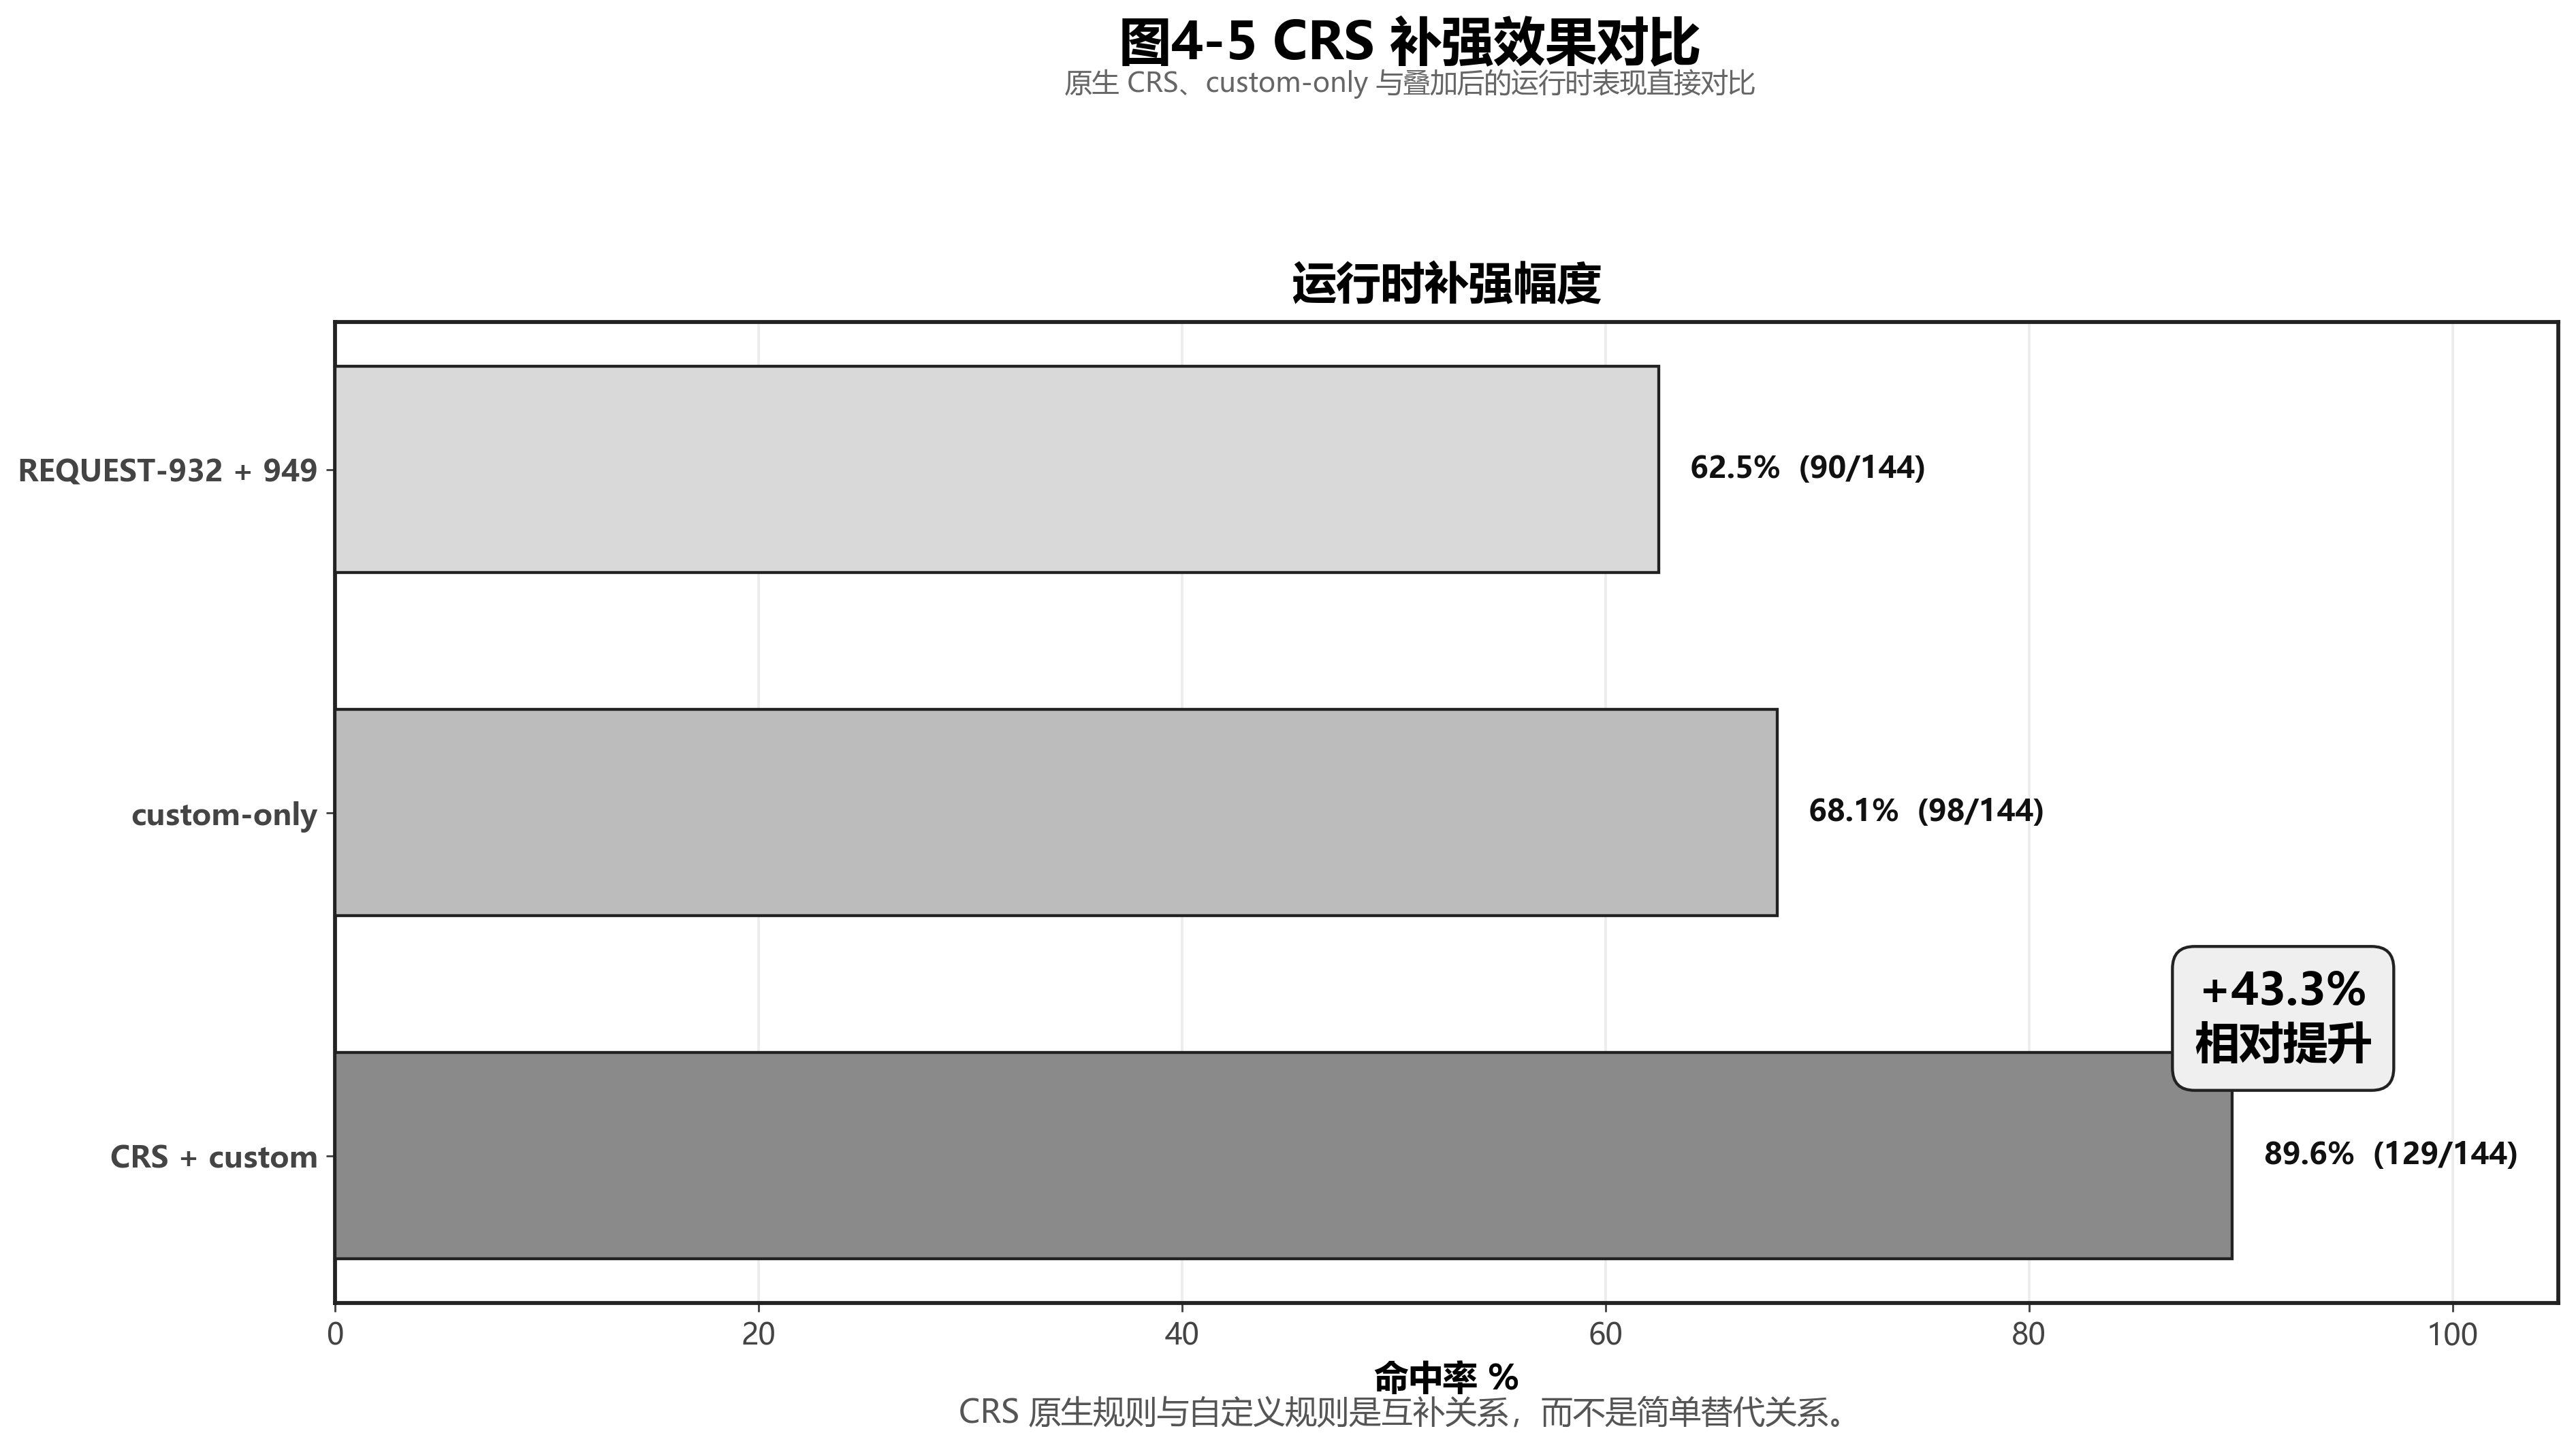
在 WSL2 的 Apache + ModSecurity + CRS 真实环境中,用 144 条 attack-only 冻结泛化集逐条发送 HTTP
请求,统计 WAF 实际拦截数。
运行口径
文件
命中
含义
仅 REQUEST-932 + REQUEST-949
crs_932_attack_result.json
90/144
只加载 CRS
自带的命令注入规则,过滤 90 条
custom-only
custom_only_attack_result.json
98/144
只加载自定义的 11 条规则,过滤
98 条
CRS + custom
crs_custom_attack_result.json
129/144
两者并行,过滤 129 条
说明:自定义规则确实带来了增量,而且不是只在离线评测里好看
综上6个结论:
聚类阶段能把 737 条样本压成 63 个家族;
投票阶段没有“自动全通”,说明后面人工筛选是必要的;
最终 11 条紧凑规则是当前最稳的版本;
纯误报集里已经做到 0;
真实运行时对 CRS 基线有明显增量。
exe打包以及setup打包
打包工具:PyInstaller 6.14.1把项目压缩为CRSRuleMiner.exe
|
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
| 打包方式:CRSRuleMiner.spec 配置文件,一键打包
入口:app.py
资源:static/ + templates/ 一起打进包
输出:dist\CRSRuleMiner.exe
console=False(启动不弹黑窗)
启动流程:双击 exe → 自动拉起 FastAPI 本地服务(端口 8000)→ 打开桌面窗口 →
搜索、预览、导出全能用。关掉窗口,后台服务自动退出。
6.19补:
之前的安装包只带了单个exe,安装后项目文件不完整。
现在改为先把根目录中需要交付的文件复制到installer\payload\,再由 Inno Setup 递归打包。
打包时排除了build/、dist/、venv/、__pycache__/、installer/等构建目录,避免把临时产物一并带入。
工作台包含内容:
主界面展示:
分为左中右布局,整体弹窗以及风格参照apple以及个人喜好
左:流程介绍,核心数据,数据一览,运行环境
中:概况介绍,重要数据,结果按钮,报告摘录
右:高级搜索,搜索结果
高级搜索框:搜 payload、搜文件名、搜数字(如 63/64、CRS),支持按范围、文件类型、类别三层筛选
中间有两个按钮——聚类结果以及复现流程,可以点击跳出独立的内容弹窗
点击复现流程,可以在复现过程中快速核对每一步是怎么做的
点击聚类结果:点击后打开独立弹窗,里面显示了变种之后的总样本数,划出同源样本集之后产生的簇数,
噪声书,以及噪声率,噪声样本示例,簇分布,簇分布可以展开
簇展开
噪声示例
文件展示:文件一览以及搜索可以查看每一个文件,以及包含该文件的文件名,文件路径,类别,类型,行
数,摘要,右上角以及Esc均可关闭
注意:exe 依赖本地文件完整存在,如果数据文件缺失,界面显示为空,不会伪造内容。下载后首次启动有
索引时间,属于正常扫描开销。
最上方有刷新索引按钮,如果后期文件更新,直接刷新索引就可以展示当前最新文件,
七:AI 对话记录与项目历程
在项目开发过程中使用 AI 助手(gpt5.5,cluadecode,deepseek,claude.ai)辅助:s
因为整个方案讨论的过程,文字长度,以及时间太太太太太冗长,只能贴一些重要部分,中间经历了一些修
改
比如把第一版已经做好的K-means+pca降维改成了HDBSCAN聚类
比如第一版做出来的项目关注的命令过于泛散,深度不够,最后只能大改专注于一个cat命令,重新写
比如第一次贸然的提交了crs社区的pr因为格式不对不够详细而被社区审核者驳回
比如
(第一版文章)
(第一次提交pr)
|
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
| Ai在代码实现方面的确很强,但是创新方面与真正决策还是不如人意,而且deepseek的专家模式真的难用至
极,知识库只截至于2025年5月,对于新发展的内容判断很容易出错!
初代大纲:
以下是我们的一些对话截图:
Claude在收集数据方面帮我搜索了不仅限于国内的catpayload来源:
Claudecode拉去下载文章,提取payload,并进行清洗去重:
但是幻觉严重,必须进行去重:
DEEPSEEK:
帮我真正的理解项目,以及新的名词(消融实验,聚类,机器学习,混淆矩阵等等...),帮我真正理解codex
的代码,算法,调整提交pr的格式
但是有时候会犯错
帮我正确调用api:
Codex(代码主力,修bug主力):
部分prompt是与deepseek交流后生成的,在写prompt的时候避免ai幻觉,需要反复强调真实
现阶段完结撒花!~感谢观看
|
页面 12
图示
第 13 页
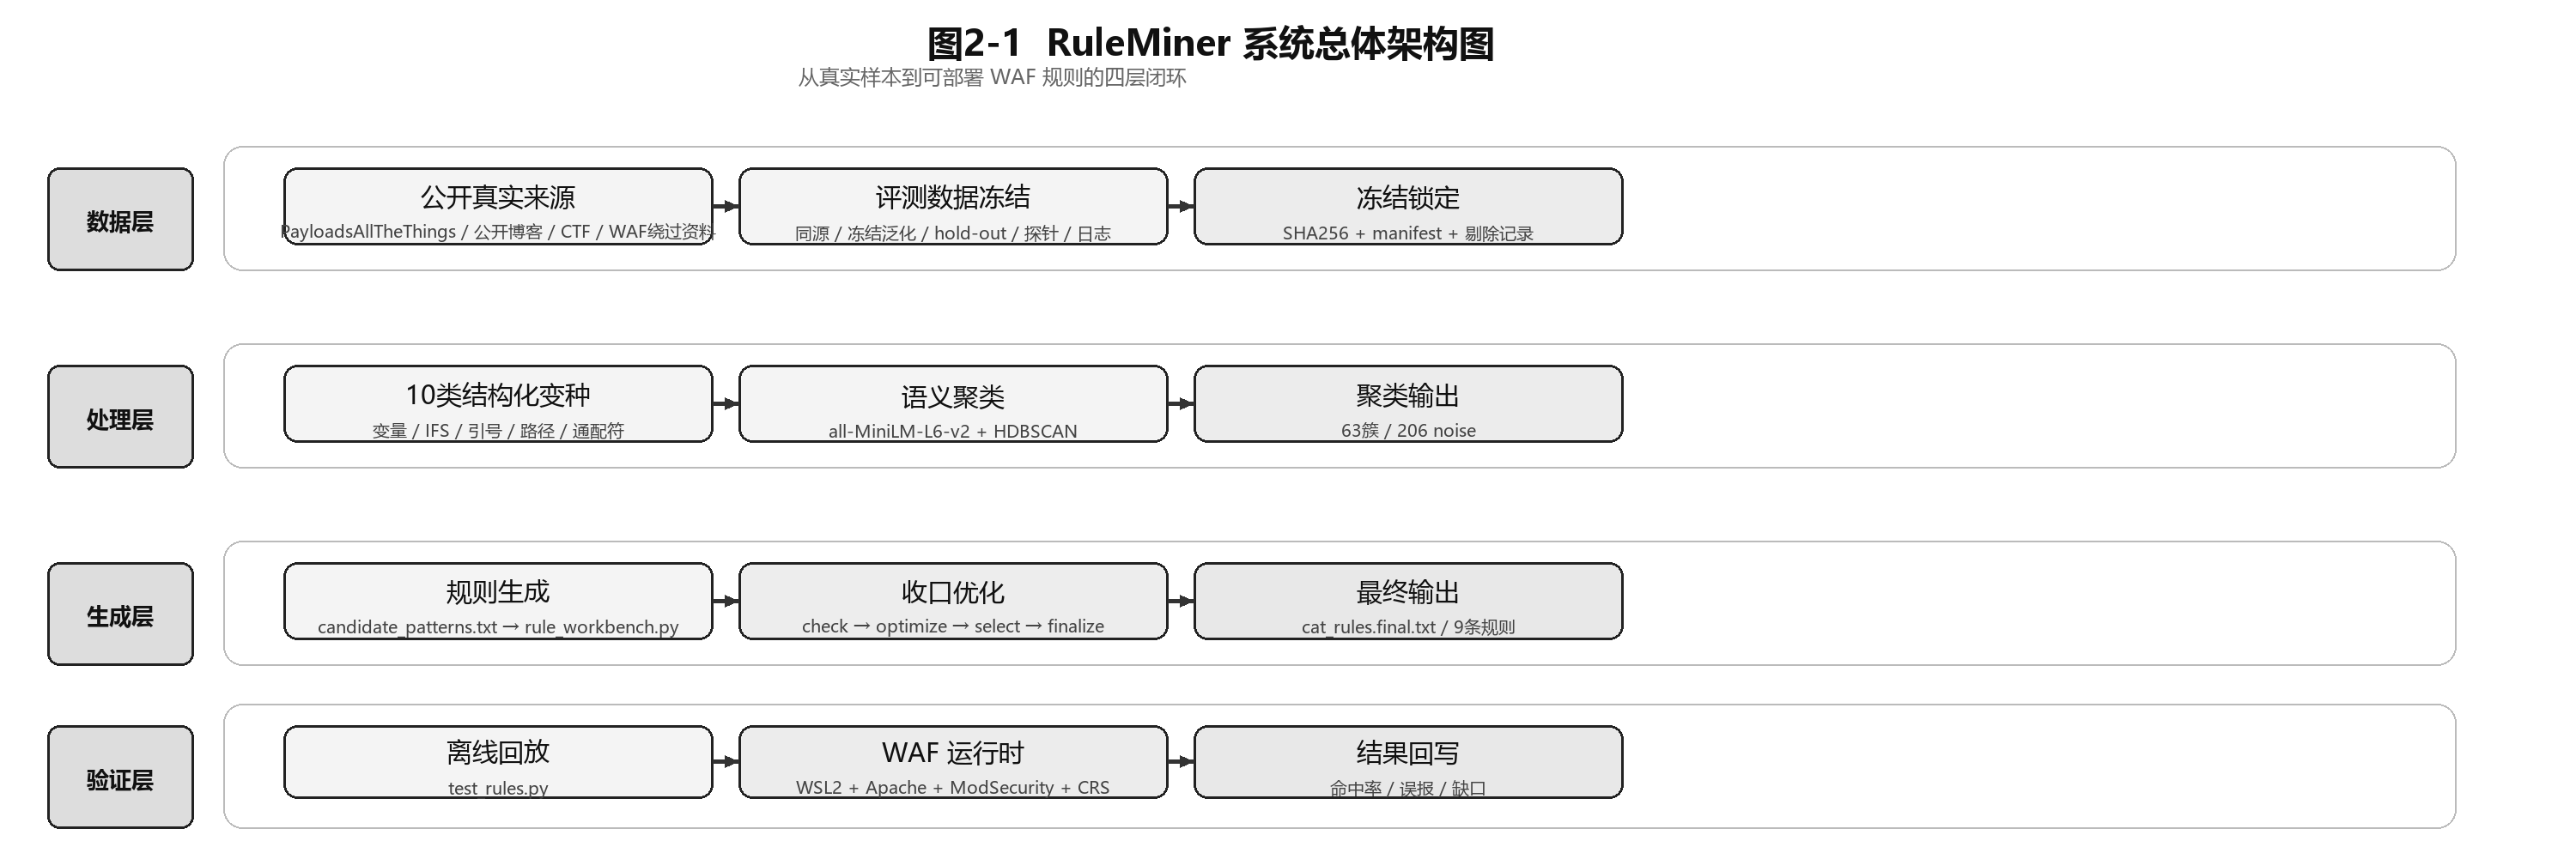
 figure_2_1_system_architecture.png
第 14 页
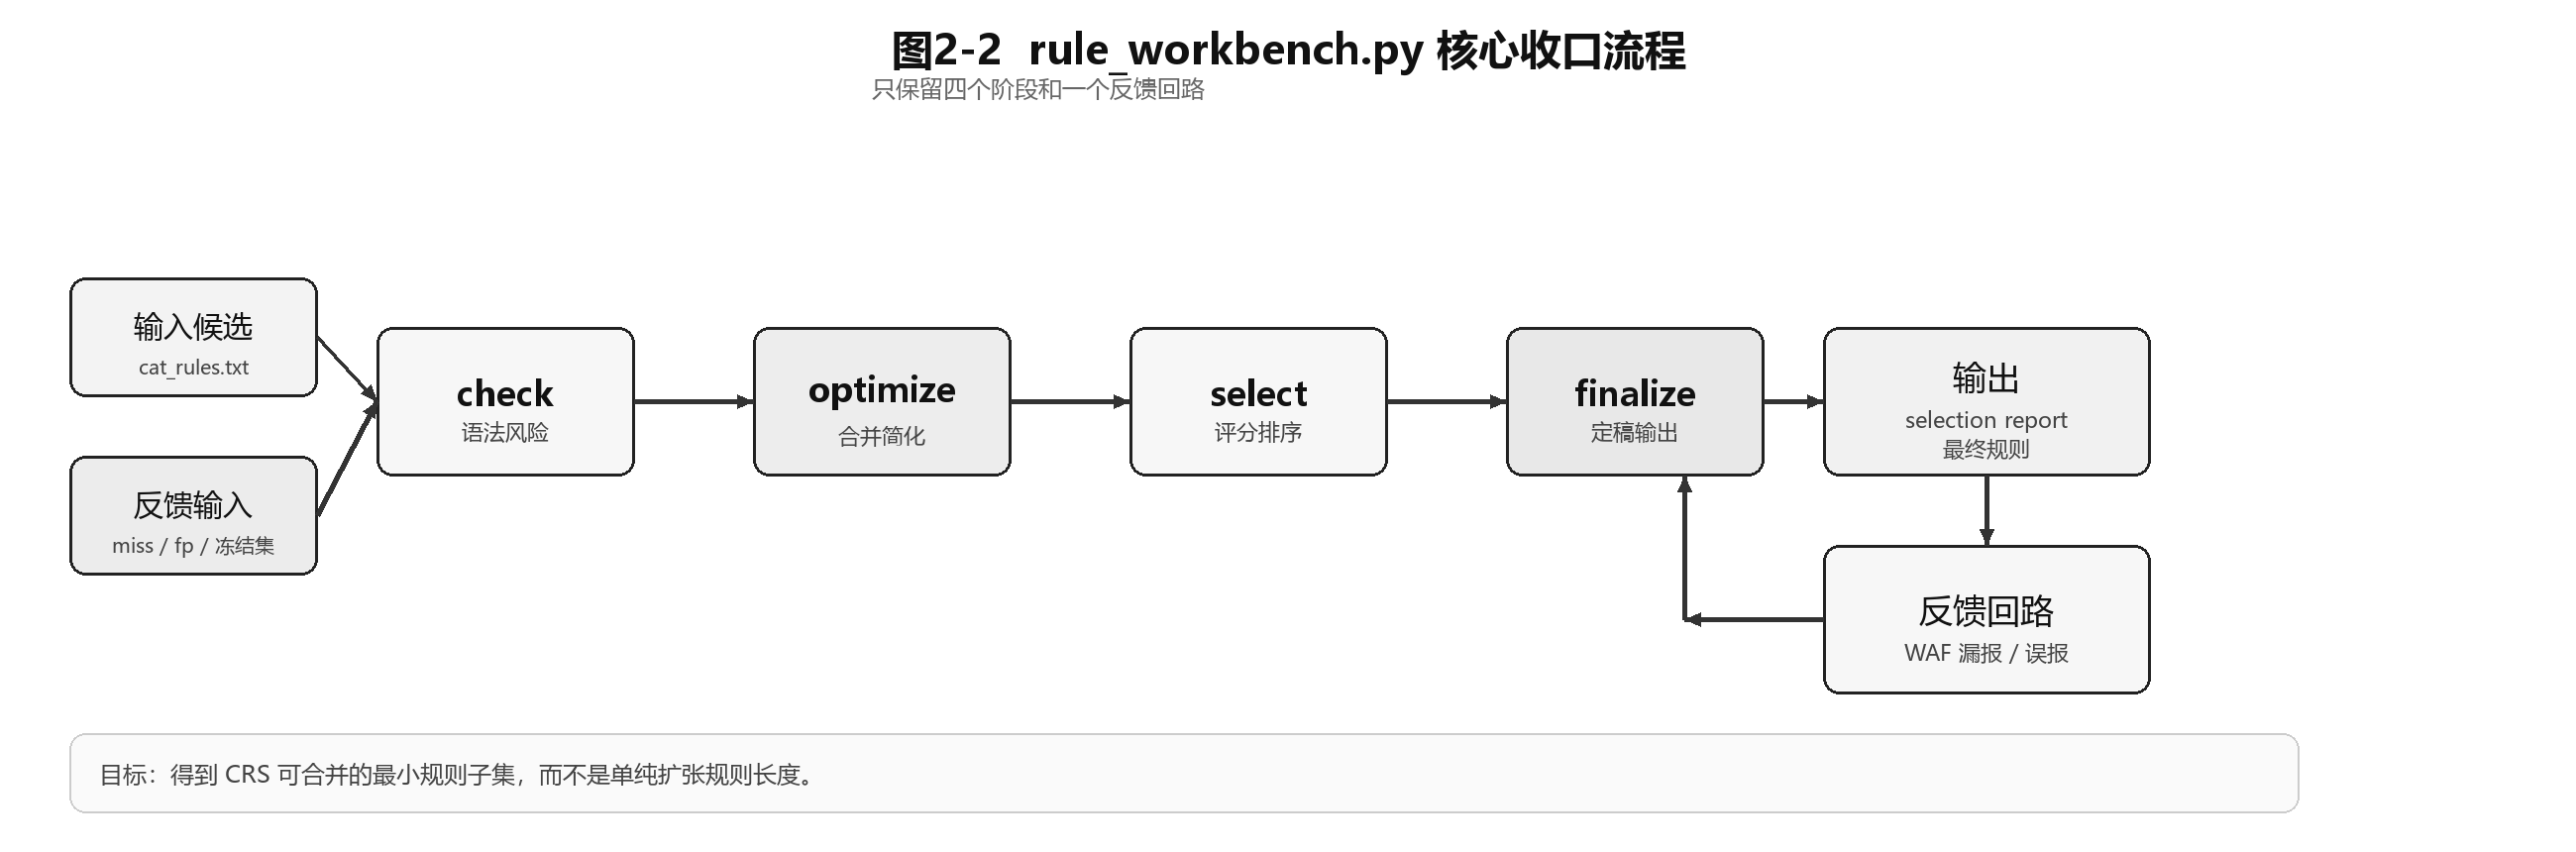
figure_2_2_rule_workbench_flow.png
figure_2_2_rule_workbench_flow.png
第 15 页
figure_2_4_software_flow_vertical.png
figure_2_4_software_flow_vertical.png
第 16 页
figure_3_1_test_closure.png
figure_3_1_test_closure.png
第 17 页
figure_3_2_waf_environment.png
figure_3_2_waf_environment.png
第 18 页
figure_3_2_waf_results.png
figure_3_2_waf_results.png
第 19 页
figure_3_3_runtime_compare.png
figure_3_3_runtime_compare.png
第 20 页
figure_3_4_baseline_gain.png
figure_3_4_baseline_gain.png
第 21 页
figure_3_5_boundary_pressure.png
figure_3_5_boundary_pressure.png
第 22 页
figure_4_1_cluster_summary.png
figure_4_1_cluster_summary.png
第 23 页
figure_4_2_stability_filter.png
figure_4_2_stability_filter.png
第 24 页
figure_4_3_frozen_loop.png
figure_4_3_frozen_loop.png
第 25 页
figure_4_4_workbench_finalize.png
figure_4_4_workbench_finalize.png
第 26 页
figure_4_5_crs_gain.png
figure_4_5_crs_gain.png
作品原创性声明
1
2
3
4
5
6
7
8
9
10
11
12
| ?????
附件3:
作品原创性声明
本参赛团队郑重声明:本团队在第十九届全国大学生信息安全竞赛(作品赛)暨第三届“长城杯”网数智安
全大赛(作品赛)所提交的作品 RuleMiner——面向WAF的检测规则自动生成化系统 ,是团队同学在指导老
师的指导下,独立进行研究工作所取得的真实研究成果,从创意到实现均为原创。除作品报告中已经标注引
用的内容外,本参赛作品不包含任何其他个人或集体已经发表或撰写过的研究成果。对本作品的研究做出贡
献的个人和集体,均已在报告中以明确方式标明。本团队及作品严格遵守竞赛组委会颁布的参赛要求,并且
无侵害他人合法权益行为和违反相关法律法规行为。本团队对该作品拥有完整、合法的著作权及其他相关权
益。本声明的法律后果由本参赛团队承担。
作品参赛团队组员(签名):
2026年 6 月29日
|